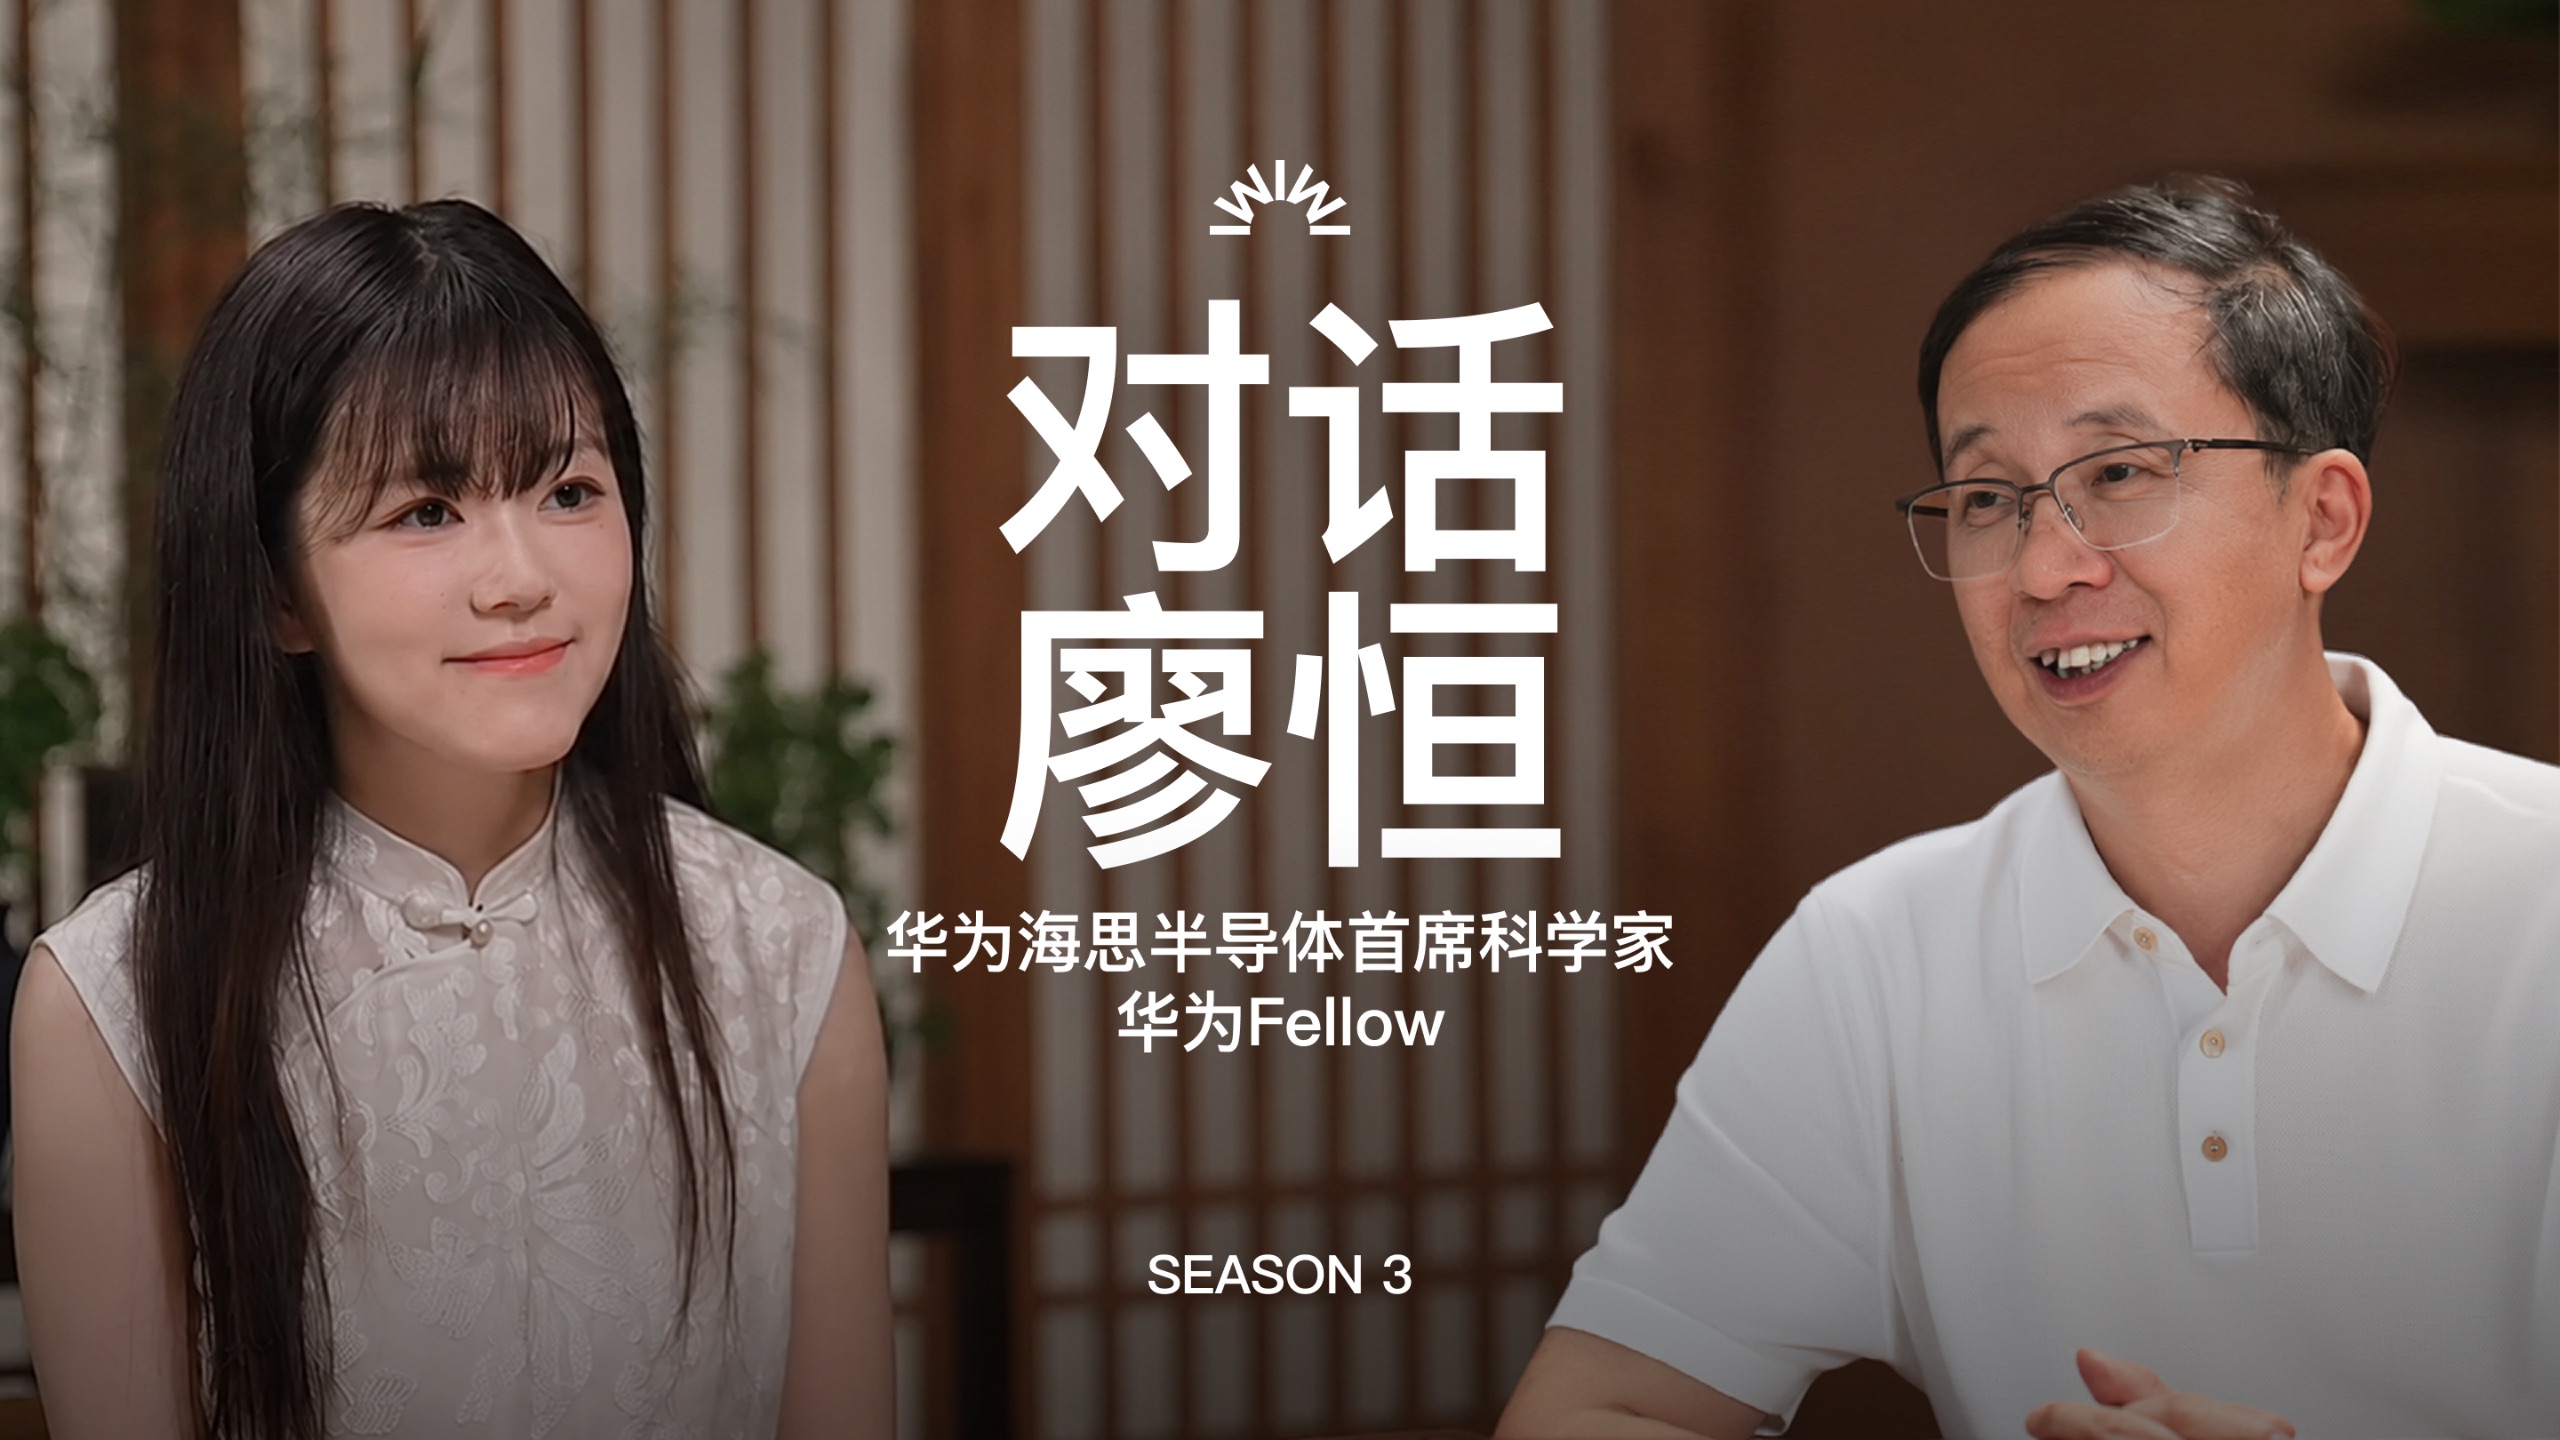
廖恒罕见露面:摩尔定律只死了一条腿——18层宝塔、昇腾十年与「做密/做松」的路线分岔
PART 01三十年一轮回:为什么越成功的上层,越容易压死底层
廖恒把全球半导体近四十年的产业史,概括成「两条纵线 + 若干横波」。这是理解后面所有判断的地基。
纵线一:处理器
约 1984–86 年起,IBM PC 把桌面办公终端做大,随后进入企业 IT 服务器。人类进入数字世界后,全球基础设施以 CPU 为中心。约 2005–2006 年起 AI 掀起新浪潮——仍属这条线的延伸与突变。
纵线二:通信与连接
电话线 modem → 宽带 → 光纤,城市间、国家间干线;移动网络与星链构成 wireless infrastructure。智能手机一度消耗全球半导体 60%–70%。
横波:狂热 → 夕阳 → 再狂热
约 2005–2015 年前后,硅谷 VC 几乎不投芯片创业Broadcom 模式代表的是「成熟利润公司并购重组、降本提效」的收割逻辑。
反直觉命题
为什么互联网之后会有 10–15 年日落期?恰恰是某些上层极度成功 → 形成垄断 → 反过来压制底层芯片的创新与利润。
他给出的这条因果链,是整场访谈里最有解释力的部分,也最能直接换算到今天:
PART 02摩尔定律没有死,死的是它的「经济性」
这是整场访谈里被引用最广、也最容易被误读的一条判断。廖恒的原话非常精确:死掉的是摩尔定律三条腿里的那一条。
| 维度 | 过去五十年 | 现在(约 7nm 后) | 结论 |
|---|---|---|---|
| 经济性 | 晶体管成本持续下降,撑起电子产品数十年反通胀 | 单位晶体管成本不降反升;台积电 3nm 晶圆比 5nm 贵一倍多,2nm 还要再翻 | 已失效 |
| 性能 | 晶体管更小 → 更快 | 近年提升很小。翻转速度受 RC 制约:线细则电阻变大,近年电阻变差、电容未明显变好 | 边际递减 |
| 能效 | 更小的「水桶」翻转能耗更低 | 仍有清晰收益,也是中国与先进工艺差距的主要落点 | 仍有效 |
最有价值的不是这个结论本身,而是他给出的换题方法:
「不能再用纳米这种长度的尺度去描述它,应该要用原子的数量去描述。换一道题——从空间尺度换到时间尺度(一秒能做多少次运算)和能量尺度(每翻转消耗多少焦耳)——也许答案就不一样。」
—— 廖恒他用「捕鼠器」来反驳「只要复现台积电就能赢」的想法:1900 年美国专利局长曾建议取消专利局,理由是「该发明的都发明完了」——但捕鼠器专利至今仍有成百上千种,机电教科书的第一页就列着十种灭鼠法(化学毒、机械夹、高压电……)。问题定义 + 有效解法 + 经济性 + 可重复,这四件事合起来才叫工程。而复现别人,第一并不需要,第二你也不具备同样的 context 与先决条件。
PART 0318 层宝塔:为什么黄仁勋的「五层蛋糕」不够用
这是本场访谈最具原创性的框架,也是最容易被当成修辞而忽略其实质的一条。廖恒认为差别不在颗粒度粗细,而在两套完全不同的切面:
黄仁勋的五层蛋糕:产业价值链
能源 → 芯片 → 基础设施 → 模型 → 应用。关心的是谁在这条链上赚什么钱。他不提矿石、光刻、wafer——那些层早被台积电、ASML、应用材料解决了,从来不是英伟达要担心的事。
廖恒的 18 层宝塔:制造物理链
矿石 → 器件设计 → wafer 制造 → 工艺制程 → 堆叠 → 芯片架构 → 编译器 → 软件 → 应用。关心的是一个芯片怎么从沙子变成能跑 DeepSeek 的东西。因为被断供后这条链上每一层都可能断。
8:1 与 32:1:一个「微观到没人这么描述过」的差别
为了让 co-design 不再是口号,廖恒给了一个可以立刻验证的例子——向量算力与矩阵算力的配比:
| 类比角色 | 硬件单元 | 英伟达 Blackwell | 昇腾 |
|---|---|---|---|
| 重体力活(矩阵乘法) | Tensor Core / Cube | 32 | 8 |
| 精细活(门控、稀疏选择、归一化、激活、排序) | Vector 单元 | 1 | 1 |
| 配比 | — | 32:1(别墅,可以浪费) | 8:1(公寓,必须精算) |
| 匹配的计算范式 | — | 稠密暴力派:每个参数都算一遍 | 稀疏精细派:先挑再算 |
DeepSeek 的巧合正在这里:MoE 稀疏激活每一步只唤醒约 1/32 的参数,「挑哪些参数参与」本身消耗的是 vector 算力。这条路径恰好落在 8:1 的昇腾上跑得动,而在 32:1 的 Blackwell 上,反而是 32 个大力士等 1 个精细工挑完再开工。
「我们的芯片恰好是 Blackwell 四分之一的规格,但是在跑 DeepSeek 的时候好像也还可以——这就是 co-design。」
—— 廖恒,并补充「我必须给梁文锋热烈鼓掌」他给出的理由是先验者的价值:梁文锋不是等到五年后算力穷途末路才被动应对,而是在大家还在卷参数时就主动选择了更难收敛的算法路径。顺着这个观察,他还给了一条管理学判断:问题的定义本身就占了约 80% 的 credit,真正找到具体解法只占 20%。
PART 04昇腾十年:从「盲猜」到「可检验」
这场访谈之所以被称作「海思第一次开口」,是因为它第一次把 910 到 950 之间那四五年怎么从盲猜走到可被证伪讲了出来。
有世界最先进的逻辑工艺,却没有方向
拥有当时最先进的工艺条件,但对 AI 生态、模型与应用方向一片迷茫——「世界亦迷茫」。想到训练,但那个市场几乎不存在;退一步想在耳机、手机等边端找变现;没有人预见到后来大模型推理与 AI coding 会变成产业。此时的架构设计,本质是盲猜。
恐惧、好胜心,以及看不见的保供
团队大约 5%–10% 去找新出路,八九成骨干反而被激发出解题热情。「可能再过几个月就彻底造不出芯片,整个商业闭环要断掉」的压力,被少数能顶的领导封锁在小范围内。他还提到一件几乎没人知道的功绩:中国的 5G 建设没有断供、没有明显推迟——背后是把大约五千到一万块单板全部重做换件、快速重回量产。「没出事」被当成了理所应当。
条件极苛刻,但终于可以打磨
停滞的 4–5 年里,算法侧大模型全面爆发:LLaMA 等开源把模型「扒开裸体」给了架构师微观设计依据;DeepSeek、千问、视频多模态持续开源;自驾与手机业务闭环给出真实反馈。推理爆发后部署一两个月就发现——decode 阶段算力没那么关键,内存带宽极其重要。通信颗粒度也量出来了:原以为要搬 1MB,实际常搬 7–8KB(大鹅卵石填箱留缝,要用细沙和水填满)。
这一段里最能改变实务判断的,是他给「和模型公司协作」划的三个等级:
| 等级 | 工作量 | 寿命与复用 | 是否可人力跨越 |
|---|---|---|---|
| 推理适配 | 最低 | 约半年到一年,可复制部署 | 可以 |
| 生产型训练 | 约为推理的 3 倍(还要补反向算子) | 随模型迭代重来 | 大规模训练仍可人力跨越 |
| 研究迭代 | 数十名算法人员每天改代码 | 持续 | 必须靠更先进的编译栈。 |
他的判断是:第三层「未来大约一年内」会部分到达。这也是为什么 CANN 必须一边做 legacy(一对一保护 CUDA 生态能力,服务高校长尾教学),一边做先进性(服务少数生产调优者——对他们而言每卡吞吐直接等于收入,极致提升 10% 吞吐就是 10% 收入)。
「哪个更难——是纳米级的物理,还是超过 CUDA 的生态?我说是超过 CUDA 更难。因为这等于改群体的习惯,就像说服所有人放弃微信去用一个新的 IM。而芯片大约 70% 的要素在自己手里,只有 30% 是物理约束。」
—— 廖恒这也是他解释「为什么开源不难决定」的方式:人与人的沟通带宽极低(说话约几十字每秒,约 kbps 量级),而芯片互联可达 TB/s 量级。在一条本来就极窄的 channel 上再装一扇 NDA gate,交付一个复杂技术体系的成本会被成倍放大。开源等于把代码摊开,减少口舌对齐的成本——顺带也利于 AI 辅助编程吃到语料。
PART 05「做密」还是「做松」:两条算力路线何时撞墙
这是全场最锋利的一段——他把两条路线之争从商业选择,上溯到了物理约束。
「你以为在买 GPU,其实主要是在买内存」
而被忘掉的物理事实:光为什么不能用混沌的方式塞进去
NPO(Near Package Optics)案例是整场访谈里工程直觉含量最高的段子,也最能说明「做松」不是偷懒:
- 必须光,但不能一步到位。超节点把芯片拉远就只能用光;HiOne 7.2T 光模块(市面常见约 0.8T,约 9 倍)放在芯片边上约 1–5cm,去掉面板侧数十厘米电缆的「八爪鱼」。
- 不塞进 package 里。旁侧千瓦级发热会让折射率随温度巨变,激光器也更容易失效。
- 光源放里面并做冗余。坏了还有一个;但绝不把高功率光源放外面再分 72 路——72 倍能量热点极易烧坏,那就不是光模块而是切割机了。
- 依据来自约 2008–09 年的跨界学习。他预感电 IO 的距离迟早不够,赴欧洲暑期班学光芯片。折射率、温度、激光器失效、每次耦合零点几 dB 的损耗——这些都是「高中物理级的事实」,却常被产业争论忘掉。
PART 06人才、算力与「工程师的手艺」
访谈的后半段从芯片回到了人。这一段最值得记录的原因,是它和当下所有关于「AI 会不会取代程序员」的讨论正面冲突。
「软件可以十分钟写一段,立刻编译运行。芯片 18 个月才按一次按钮,一次错误或烧掉数亿人民币。一皮秒的 timing、一根线都不能错。」
—— 廖恒怎么长成一个芯片人
天才博士不够,必须做过芯片。模块到子系统通常要 18–20 个月,而且要经历多次完整的投片、验证、量产周期。首要是靠谱、负责、严谨——听起来不性感,但很底层。
「喇叭口」要张开
fabless 在大约第 7 层,就必须理解第 6 层和第 8/9 层,还能跟算法对话。多问「兆瓦散热要多少面积」这类跨层问题,久而久之就能预测对方下一步会怎么做。
算力真的缺吗
高校往往远比海外充裕(国家实验室万卡级 vs 国外一系仅数百至千卡)。企业里真正有价值的团队一般也拿得到算力。反例:DeepSeek 以千卡级实现了极高突破,说明算力不是大模型的主瓶颈。
「八大件」缺一不可
CPU/NPU、内存、SSD、网卡、交换机、光模块……缺一件,十万卡甚至二十万卡的系统就会被 legacy 拖垮。以太体系要做到世界第一梯队无代差,同时自 2019 起做灵衢——并把协议 license-free 公开。
三次「悲观的错误判断」:全篇最锋利的自我复盘
| 他当年的判断 | 理由 | 后来 |
|---|---|---|
| 反对做 ARM 服务器 CPU(后来的鲲鹏) | x86 生态太强,除非便宜到 1/3 或性能 3 倍 | 今日 ARM 服务器在云上预计可超 x86,中国每年百万级部署 |
| 反对昇腾早期做训练卡 | 2016 年中国互联网还没开始自训模型,主张做能卖出去的边缘产品 | 数据中心收入规模远大于边缘 |
| 低估数据中心的爆发式需求 | 看好边沿、不看数据中心 | 完全相反 |
张小珺点破了这三件事的共同特征——都是基于悲观预期做选择。他坦然承认这与自己亲历美国芯片行业衰退有关,「也许训练了我一种首先看到事情不行那一面的习惯」,也承认华为领导的格局比他大得多。这段复盘真正值钱的地方在于它证明了一件事:连顶级架构师的先验认知都不可靠,所以组织必须留出被现实纠错的通道。
PART 07哪些判断要先打折:一份诚实的边界清单
⚠️ 五条需要先打折再看的结论
- 「约 80% 成本来自 HBM」是成本结构的经验比例,会随型号、时点与供应链剧烈波动;把它当成普适定律会误判。
- 「做密第四代大概率不行」是物理推演,不是实测结论。他本人给出的措辞是「也许还能做 1–3 代」,属于趋势判断。
- 「100 平米公寓」的类比说明了约束,没有说明结果。8:1 是架构选择,而非工艺被迫;把「受制裁」直接等同于「8:1」会漏掉他反复强调的主动设计成分。
- 这场访谈有大量第一人称回忆(PMC 出售价、流片命中率、5G 保供单板数量等),多为口述历史,缺少可核对的第二方证据。
- 产业格局判断带有明确立场。他本人是华为 Fellow,关于「中国道路」的表述应以他给出的可证伪标准为准——看 fabless / 代工 / 内存 / 封装的财报能否经济闭环,而不是口号。
PART 08如果只带一句话走
SUMMARY一张表带走:六个核心判断及其依据
| # | 核心判断 | 她/他引述的依据 | 可信度 |
|---|---|---|---|
| 01 | 上层越垄断,底层越容易凋零 | 产品定义到用户手里约 3 年,「我的日历在 2030,客户生活在 2026」;PMC 被 Broadcom 模式清盘 | 高(机制清晰) |
| 02 | 摩尔定律死的是经济性,不是全部 | 16nm/7nm 后单位晶体管成本不降反升;只剩能效仍有收益 | 高(行业公认) |
| 03 | 18 层宝塔,上限由最短的那层锁死 | 第 4 层改动=18 个月+2–3 亿;第 10–13 层小时级迭代 | 高(框架自洽) |
| 04 | 8:1 遇稀疏化=co-design 的最佳案例 | vector/cube 配比;DeepSeek 每步只唤醒约 1/32 参数 | 中高(含巧合成分) |
| 05 | 「做密」有物理天花板,「做松」是受限条件下的解 | N² vs N 的 gap;单机柜功耗四年到兆瓦级;(他自承这是趋势推演) | 中(推演非实测) |
| 06 | 超过 CUDA 比造纳米级芯片更难 | 改群体习惯的类比;人和人沟通带宽 vs 芯片互联带宽的差序 | 高(经验充分) |
Key Points 总结
- 两条纵线 + 若干横波:处理器线 × 通信线;上一轮上层垄断造成的八年日落,是本轮最该被警惕的剧本。
- 摩尔定律只死了一条腿:经济性失效,性能边际递减,只有能效仍在兑现——这就是「换考题」的窗口。
- 18 层宝塔不是分类学,是节奏表:底层慢、上层快,用上层的快速试错反向校准下层。
- 稀缺的不是专家,是能纵向贯通的人——「像一根线把珍珠串成项链」。
- 竞争力在内存:约 80% 成本在 HBM,推理 decode 阶段带宽比算力更关键。
- 「做松」的物理依据:算力随面积平方增长,而 IO/供电/HBM 只沿周长线性增长。
- 三次误判的共同特征:基于悲观预期做选择——这是全篇最有复利价值的一段自我复盘。
② 公开流传的两份完整访谈整理稿(主线 11 章结构稿 + 18 层宝塔专题对话稿),本文在此基础上按视频官方简介 OUTLINE 的七章重组;
③ 视频简介 OUTLINE 章节时间轴(00:02:08–04:16:45),用于本文开头的对照;
④ B站开放接口
x/web-interface/view 提供的时长、封面与发布信息。