
Jev 判断引擎实操指南:不开源没关系,开源版 Laya 本地三步跑起来
AI 工具箱 · 手把手实操
2026.10
Jev 判断引擎实操指南:不开源没关系,开源版 Laya 本地三步跑起来
TypeSafe 判断引擎 · 只回答 choice / score / noul 三种问题 · Laya 接口兼容本地部署 · 快≠准的冷思考
Jev 判断引擎实操指南:不开源没关系,开源版 Laya 本地三步跑起来
实操教程
TypeSafe 发布了一个「不是聊天模型」的模型:Jev。它一个字都不生成,标称比主流大模型快 193 倍、成本只有 1/400;你没法跟它聊天,它只回你一个判定,还附带该不该信它。它不开源、官方注册这几天也暂停了——所以本文不光讲它是什么,还把开源兼容版 Laya 在本地完整跑一遍。
01
PART
Jev 是什么:判断引擎,不是聊天模型
JUDGMENT ENGINE, NOT CHATBOT
普通 LLM(Claude、GPT)一个字一个字往外蹦:你让它分类一封邮件,它得先想、再组织语言、再输出一段文字,然后你的代码还得把这堆文字解析成能用的数据——三步,每一步都可能出错。Jev 跳过全部:不生成文字,直接给你一个带概率的判定,所以它的输出 token 是免费的。官方文档原话:Unstructured State in, Typed Probabilistic Decisions Out——无序的状态进去,带类型的概率判定出来。
02
PART
只回答三种问题
CHOICE · SCORE · NOUL

▲ Jev 的三种输出类型:choice 选择、score 打分、noul 概率
choice 选择:你预先定义好选项,它挑一个并给出每个选项的概率——比如这封邮件属于商务合作、订阅更新、冷启动推销还是 Agent 原生。score 打分:你定义一个刻度,它把输入放到刻度上——比如「我本人必须看的重要性」:忽略 / 低 / 中 / 高 / 紧急。noul 概率(no + null):回答一个判断题的概率——这封邮件提到商务合作机会的概率是多少?是不是诈骗邮件?
03
PART
三个真实案例
REAL WORLD CASES

▲ 案例实测:7 万封待处理邮件,先分类再行动,清理 62,000 封、释放 12GB
打游戏:它打 Doom,但只负责「当司令官」——读游戏导出的状态、选目标核心,具体操作由控制器执行,不当手脚。跑一小时实时游戏调用成本约 7 美元。
删邮件:一个塞满 7 万封的邮箱,给每封邮件分类,重要的用规则兜底,然后批量删——最后删掉 62,000 封、腾出 12GB,只花 3 块 6 毛 4 的调用费。做交易:一个交易机器人拿它做决策,每 300 毫秒下一次判断——这个频率,你不可能等一个大模型「想完再回答」。
04
PART
开源版 Laya:改个地址就能本地跑
OPEN-SOURCE LAYA

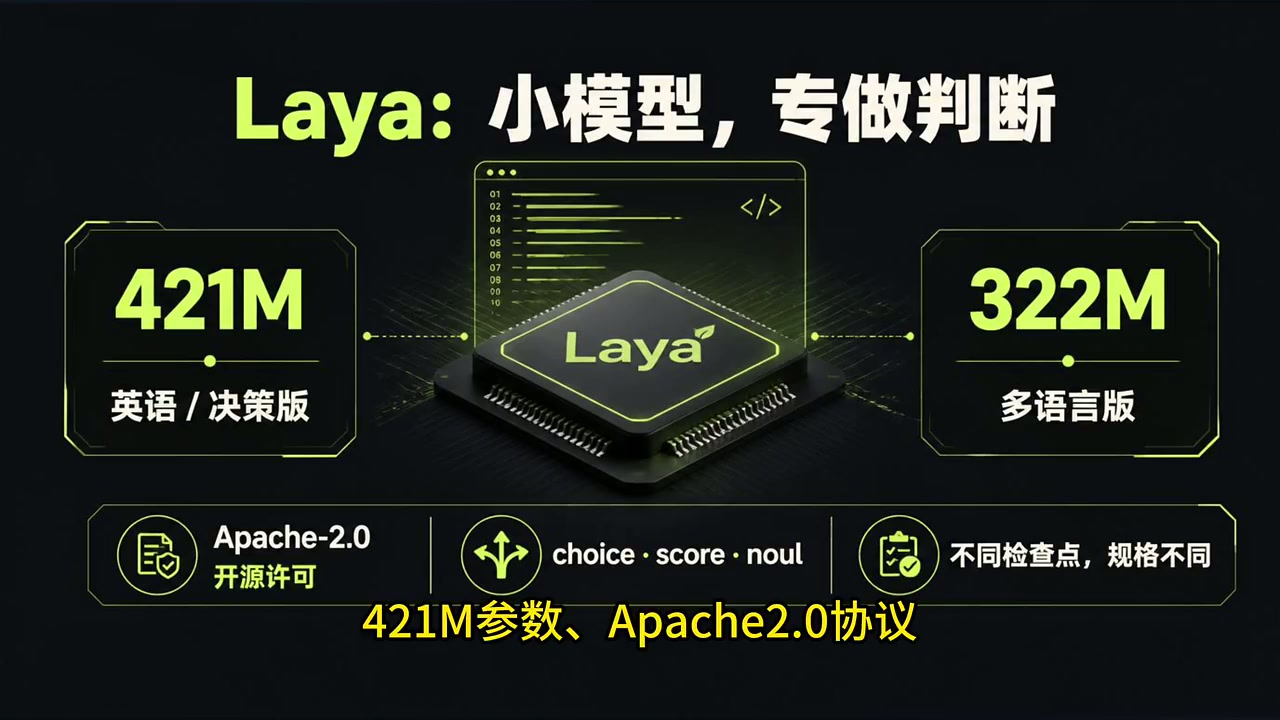
▲ Laya:421M 参数(英语/决策版)与 322M 多语言版,Apache-2.0 开源,同样只做 choice / score / noul
Jev 发布三天后,社区就放出了独立复现版 Laya:421M 参数(英语 / 决策版)、322M 多语言版,Apache-2.0 协议,8GB 内存以内能装,单次判断 33 毫秒。最关键的一点:它提供和 Jev 接口兼容的 HTTP 服务,返回数据结构跟 Jev 一样——原来调 Jev API 的代码,改个地址就能跑在本地。
和官方版差距?一组公开实测:同跑 20 张中文工单,本地 25 毫秒更快胜出;但同组质量测试里官方还是更强——速度上本地赢了,不是开源全面胜利。另一组 1000 条数据 × 40 个标签分类:本地方案 66 秒全部跑完,另一个方案跑了 21 分钟最后失败。数据量越大,本地越划算。
05
PART
本地部署三步
DEPLOY IN 3 STEPS
Laya 本地部署
# 1. 安装(Mac / PC 都能跑)
pip install laya
# 2. 拉取模型
laya pull jev-3b
# 3. 启动本地 HTTP 服务(接口与 Jev 兼容)
laya serve --model jev-3b --port 8080
原理一句话:传统模型自上而下逐字生成,Laya 一次前向传播直接算出每个选项的概率——没有文字要解析,也没有格式可以幻觉。装完不连网也能用。

▲ 本地实测:工单/邮件实时分类输出,平均延迟 47.2ms,离线运行(no GPU · offline),输出 token 费用为 0
💡 迁移成本 服务地址从 Jev 官方 API 改成本地 http://localhost:8080 即可,请求与响应结构保持一致。
06
PART
用在哪:Agent 的快慢分工
WHERE IT FITS
一个成熟的智能体架构本来就要做快慢分工:贵的调用是「下一步该干嘛」这类规划——需要长上下文、需要推理,交给大模型天经地义;但同一个 Agent 里还有大量微小、高频的判断:操作成功了吗?该调哪个工具?这条内容要不要拦?现在要不要停?这些判断答案空间固定、一次只要一个结果——拿最贵的大模型干这些活,等于让公司里最贵的员工去前台分流。
///
LAST
冷静看待:快≠准
FAST ≠ CORRECT

▲ 14 条带逻辑错误的 SQL 对比:官方 Jev 判对 13 条,本地方案只有 6 条——格式正确不等于逻辑正确
三个没那么好听的事实:第一,193 倍是厂商自测,对比自己选的参照模型,没有第三方独立复现;第二,上下文窗口只有 64K(开源版更小,只有 1K-8K),喂给它判断的输入得先想清楚塞不塞得下;第三,也是最该警惕的——快和便宜不代表判得对。
想试的话两条路:官方 API 注册虽然暂停,但挂在几个云平台上还能调,其中一家这周还免费;本地跑 Laya,Apache-2.0 一行 pip install,离线可用。最后想想你的项目里,哪些判断其实根本不需要大模型?是路由、分类,还是审核?
▶ 视频|Jev 究竟是什么:不开源但开源版已在 Mac 跑通
🔗 https://weixin.qq.com/sph/AsLaViixQS
📱 微信扫码观看
▶ 视频|三年心血 Jev 爆火,败给 3 天开源 Laya
🔗 https://weixin.qq.com/sph/AUnk4jkfq9
📱 微信扫码观看
▶ 文章|Jev 不是下一个 GPT,但它可能比 GPT 更该装进你的工作流
🔗 https://mp.weixin.qq.com/s/3U96c6p-_3WmqfvKbc1DBw
📱 微信扫码观看
▶ 视频|Jev 制作的 640 个开源项目清单
🔗 https://weixin.qq.com/sph/A3BOm98Q5V
📱 微信扫码观看
既然看到这里了,如果觉得有用,随手点个赞、在看、转发三连吧。
THANKS FOR READING