
【自动化剪辑】优秀项目合计——SKILLS
官网在这里:JianYing Editor Skill | 官方开发者指南
前两天看到一个自动剪视频的开源项目,只需要对着 AI 说:"把这些剪成一条发布视频",然后,它就自动去口癖、调颜色、加字幕,甚至做动画。
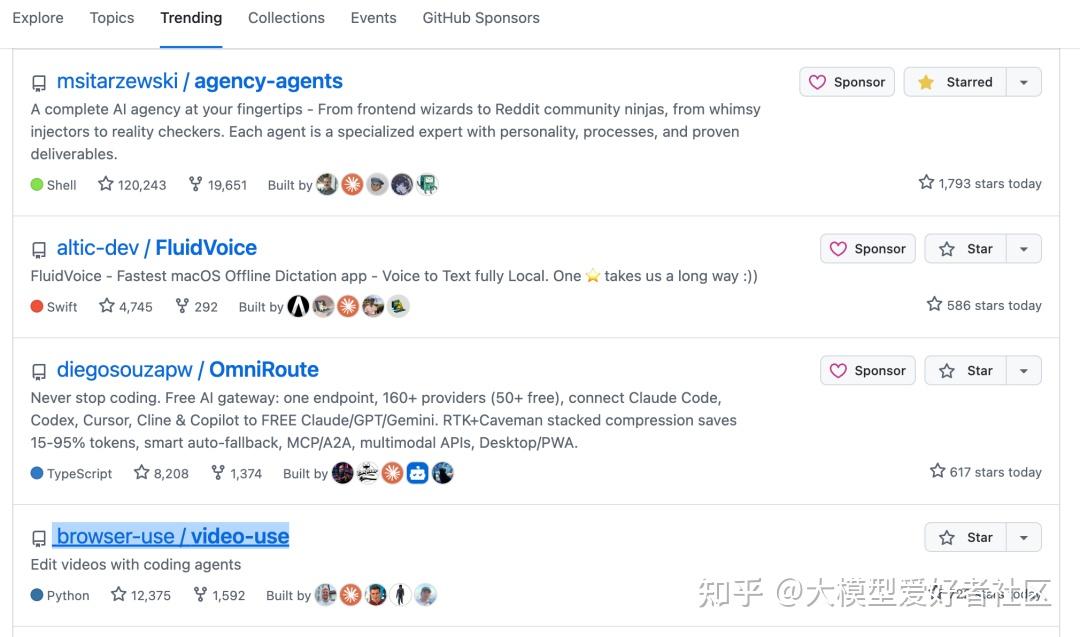
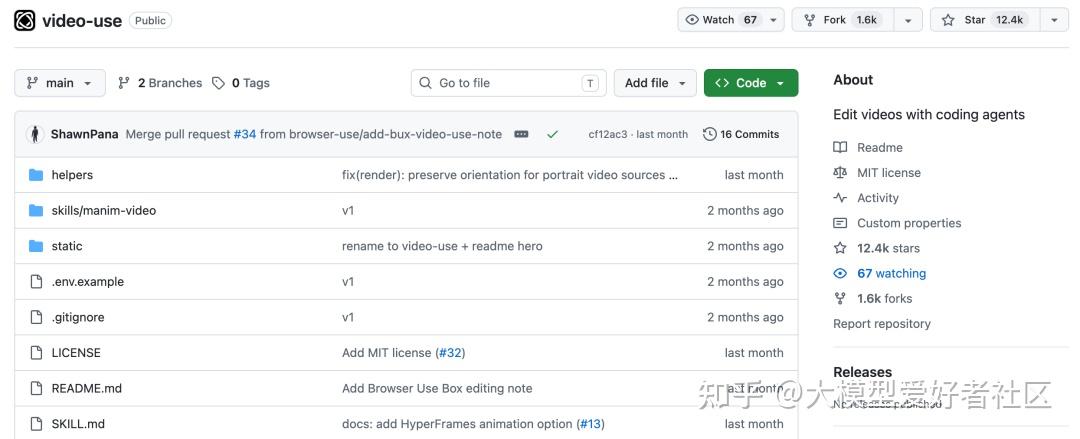
这是一个叫 video-use 的开源项目。登上了昨日 GitHub 日榜 TOP5,已有 1.2 万标星。
做内容创作的人都知道,剪辑是最磨人的环节。学习成本太高,普通人又很难上手。就连剪映这种相对简单的工具,也需要你拖动时间轴、调整参数,本质上还是在"操作软件",而不是在"表达创意"。
直到我发现了 video-use。
GitHub:https://
项目简介
video-use 是 browser-use 团队(就是那个靠 AI 浏览器自动化出圈的明星团队)最新开源的项目。
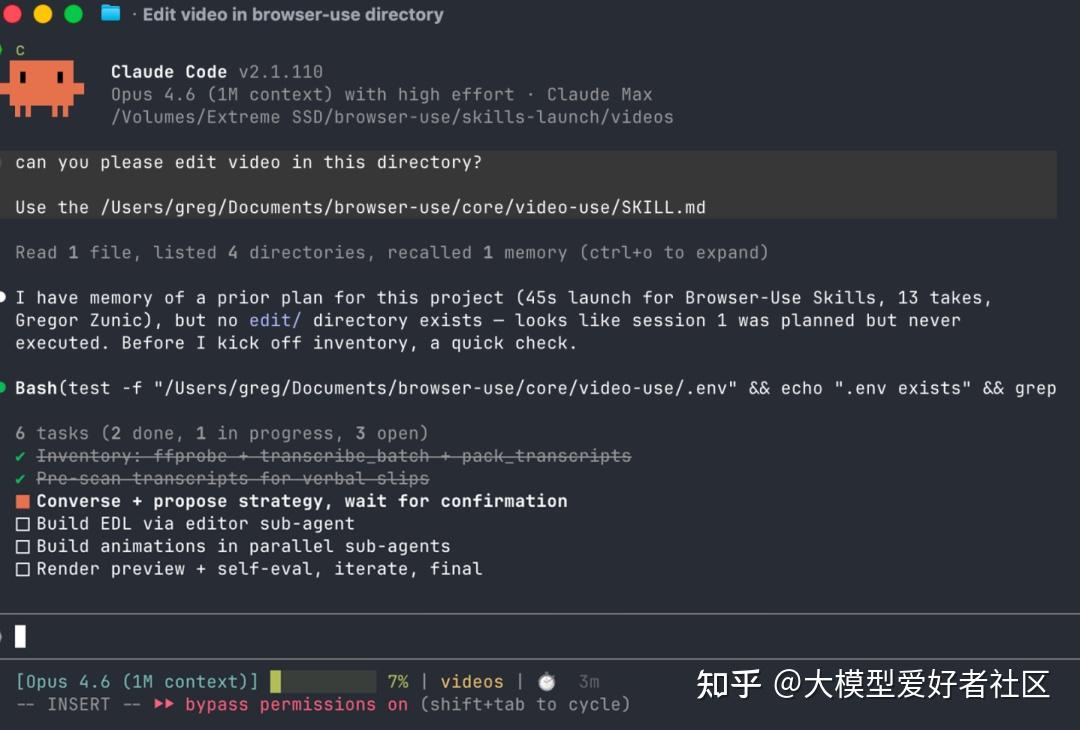
它的核心理念极其简洁:把原始素材放进文件夹,用自然语言告诉 AI 你想要什么,直接拿回 final.mp4。
这个项目上线不到三个月就拿下了 1.2 万 Star,核心原因在于它彻底改变了视频剪辑的交互方式。
传统剪辑软件让你"操作时间轴",video-use 让你"描述意图"。
你不需要学习任何快捷键,不需要理解轨道和关键帧,就像和朋友描述你想要的效果一样,AI 帮你完成所有技术细节。
核心功能
• ✂️ 智能剪辑:自动识别并剪掉填充词(umm、uh)、口误、重复句,以及片段间的死寂
• 🎨 自动调色:温暖电影感、中性增强,或自定义 ffmpeg 滤镜链,统一画面风格
• 🔊 音频处理:每处剪辑点自动添加 30ms 淡入淡出,彻底消除爆音和突兀感
• 📝 字幕烧录:默认两词大写分块样式,完全可定制字体、颜色、位置
• ✨ 动画叠加:通过 HyperFrames、Remotion、Manim 或 PIL 生成动画元素,并行子代理加速
• 🧠 会话记忆:剪辑进度保存在 project.md 中,下次打开可以继续,不会丢失上下文
• 🔍 自我评估:渲染完成后自动检查每个剪切点,捕捉画面跳变、音频爆音、字幕遮挡
技术亮点
video-use 最反直觉的设计决策是:LLM 自始至终不看视频画面。
它通过两个信息层次来理解视频内容,这个设计堪称精妙。
1、双层读取系统
第一层:音频转录层(始终加载)
每次处理素材时,video-use 通过 ElevenLabs Scribe 接口生成逐词级别的时间戳转录,包含说话人分离和音频事件标记(笑声、掌声、叹息)。
所有素材打包成一个约 12KB 的 takes_packed.md——这是 LLM 在剪辑决策时读的全部内容。
## C0103 (duration: 43.0s, 8 phrases)
[002.52-005.36] S0 Ninety percent of what a web agent does is completely wasted.
[006.08-006.74] S0 We fixed this.
第二层:可视化复合层(按需生成)
当 LLM 需要判断某段沉默是否算死空间,或者比较两次拍摄的节奏差异时,才调用 timeline_view 工具生成一张包含胶片条、波形图和词语标签的合成 PNG。
2、效率对比
传统视频分析要把 30000 帧视频传给 AI,每帧 1500 tokens,总共 45M tokens——又贵又慢。
video-use 只需要 12KB 文本 + 几张关键图片,成本和效率的差距简直是数量级的。
这就像 browser-use 不给 AI 看网页截图,而是给结构化 DOM 数据——但用于视频。
快速入手
自动安装(推荐)
直接在 Claude Code 中粘贴以下指令,Agent 会自动完成所有步骤:
Set up https://github.com/browser-use/video-use for me.

Read install.md first to install this repo, wire up ffmpeg, register the skill with whichever agent you're running under, and set up the ElevenLabs API key — ask me to paste it when you need it. Then read SKILL.md for daily usage, and always read helpers/ because that's where the editing scripts live. After install, don't transcribe anything on your own — just tell me it's ready and wait for me to drop footage into a folder.
手动安装
# 1. 克隆项目并创建软链接
git clone https://github.com/browser-use/video-use ~/Developer/video-use
ln -sfn ~/Developer/video-use ~/.claude/skills/video-use

# 2. 安装依赖
cd ~/Developer/video-use
uv sync  # 或 pip install -e .

# 3. 安装 FFmpeg
brew install ffmpeg
brew install yt-dlp  # 可选,用于下载在线视频

# 4. 配置 API Key
cp .env.example .env
# 在 .env 文件中填入:ELEVENLABS_API_KEY=sk_your_key_here
日常使用
1. 准备素材:将所有原始视频文件(MP4/MOV)放入一个文件夹,如 ~/Videos/my_project/
2. 启动 Agent:在终端进入该目录,启动 Claude Code
3. 下达指令:输入自然语言指令,例如:
edit these into a launch video4. 自动处理:Agent 会自动盘点素材、生成剪辑策略、等待你确认后开始处理
5. 获取结果:最终产物 edit/final.mp4 会出现在素材文件夹旁边
写在最后
video-use 不是给视频编辑专家的工具,而是给 「不想学剪辑,但需要产出视频」 的人。
如果你每周产出几条口播或教程视频,花半小时配置好 video-use,之后每条视频省下几小时剪辑时间,ROI 非常可观。