
Vibe coding全栈架构 —— 核心架构与技术黑话速成
我们将一个完整的项目分为三层:前端(门面)、后端(大脑)、数据库(记忆)。
🛠️ 一、 指挥中枢(你的兵器库)
这是你作为主导者的核心工具:
WorkBuddy: 你的企业 Agent 中枢。用于前期需求分析,并沉淀 Context(上下文资产)。
CodeBuddy: 你的全能开发伙伴。包含 Ask(对话补课)、Craft(局部精修) 和 Plan(全局任务生成) 三大模式。
.codebuddy/rules: 你的“军规”。用自然语言写在项目里的纯文本规则,强制锁定 AI 的编码规范。
🏗️ 二、 系统架构与组件(战场的地形图)
构建一个现代应用的“三大兵种”与它们的“武器”:
1. 前端层(门面)
Next.js & Tailwind CSS: 目前 AI 最擅长的前端框架与样式库。
Component(组件化): 把页面拆成可复用的“乐高积木”。
State(状态管理): 记住用户当前在界面的操作数据。
Server Component(服务端组件): 渲染极快,但不能包含点击等交互。
Client Component(客户端组件): 运行在浏览器,负责响应用户的实际交互(如点击按钮)。
2. 后端层(大脑)
FastAPI / Node.js: 负责处理业务逻辑的后端框架。
RESTful API: 前后端沟通的标准网络协议。
API Gateway(统一网关): 所有外部请求的统一入口,负责分发和基础拦截。
Microservices(微服务): 将大系统拆分成独立的小服务(如购物车服务、支付服务)。
Middleware(中间件): 拦截请求的关卡(如检查登录状态)。
3. 数据与存储层(记忆)
PostgreSQL: 核心“永久档案库”,主数据库。
Redis: 极速“内存便利贴”,缓存层,扛高并发。
MQ(消息队列): 异步“传送带”,把非紧急任务排队,防止冲垮主库。
Schema: 数据库的“表结构蓝图”。
ORM(如 Prisma): ORM (Object-Relational Mapping, 对象关系映射) 就是一个“高级翻译官”,数据库“翻译官”,让 AI 可以用面向对象的方式操作数据库,无需写复杂 SQL。
什么是映射? 就是你写一份简单的说明书(Schema),告诉翻译官:“我代码里的 Article 对象,对应档案柜里的 articles 表;对象的 title 属性,对应表里叫 title 的那一列。”
它的好处: 你只需要用自然语言或者简单的代码操作对象(比如“新建一个收藏”),ORM 会自动帮你翻译成完美的 SQL 语句去操作数据库。这让 AI 写后端逻辑的准确率极高。
PostgreSQL 常见的 ORM 框架:
Prisma: ⭐️ 最推荐给你! 它的配置文件(Schema)像人类语言一样好读,目前全球 AI 编程工具对 Prisma 的理解度是最高的。
TypeORM / Sequelize: 老牌经典,适合传统的企业级重型项目。
Drizzle: 最近很火的新星,主打轻量和极致性能。
Redis 缓存的作用机制
在刚才的例子里,PostgreSQL 就像是公司的 “地下室档案库” 🗄️。容量无限大,数据永久保存,但每次去存取资料都要坐电梯,速度慢,且并发处理能力有限。
Redis 就像是你办公桌上的 “临时便利贴” ⚡。它是把数据存在内存里的,容量小,但一伸手就能拿到,速度极快,能扛住巨大的瞬间流量。
在你的“点击收藏”场景中,Redis 的作用机制如下:
假设你写了一篇爆款文章,一分钟内有 10 万人同时点击了“收藏”。
如果没有 Redis: 这 10 万个请求会瞬间涌入地下室档案库(PostgreSQL)。数据库大门挤爆,直接宕机。
如果有 Redis:
挡在前线: 用户的点击会先写到桌面的“便利贴”(Redis)上,比如记录 article_123_favorites = 100000。这瞬间就能完成,用户体验丝滑。
异步落库: 然后,后端系统会每隔 5 分钟,把便利贴上的最终数字,慢条斯理地一次性搬到地下室档案库(PostgreSQL)里永久保存。
试想一下:如果数据刚写到桌面上的“便利贴”(Redis),还没来得及由系统自动搬到地下室“档案库”(PostgreSQL)时,服务器突然宕机断电了,会发生什么?便利贴上的数据就会永久丢失。
因此,在系统架构中,技术栈的选用必须跟着业务需求走。我们通常在两种策略中做权衡:
追求极致速度(Redis 优先): 适合点赞、文章浏览量。偶尔丢失几个数据,用户几乎无感,但系统能扛住巨大流量。
追求绝对安全(Postgres 优先): 工程上常叫 Cache Aside(旁路缓存)。先强行把数据稳稳地存入地下室档案库,确认安全后,再去更新桌面上的便利贴。
🔄 三、 数据的运动轨迹(业务流转)
数据一旦动起来,你需要把控这两个维度:
1. 接口的 5 步漏斗
Request(请求) ➡️ Auth(鉴权守门) ➡️ Validation(防呆校验) ➡️ Logic & DB(查改数据库) ➡️ Response(响应结果)。
2. 核心落库策略
异步落库 (Write-Back): 速度优先(如购物车)。先写 Redis ⚡,再把任务扔进 MQ 传送带,最后由后端慢慢同步到 Postgres 🗄️。
旁路缓存 (Cache Aside): 安全优先(如支付扣款)。绕过 Redis,直接开启 Transaction(数据库事务) 锁死 Postgres,确保绝对安全后,再去更新 Redis。
⏱️ 四、 团队与时间控盘(防跑偏机制)
在 AI 或团队敲代码前,必须卡住的检查点:
架构蓝图 (Blueprint): 明确服务划分和数据流转图。
API First (接口优先): 必须先出契约。
Swagger / Apifox: 自动生成接口文档和 Mock(假数据),让前后端彻底解耦、并行开发。
CI/CD (自动化流水线): 代码合并后自动测试与部署,消灭“在我电脑上是好的”的扯皮。
现在,整张地图已经全部点亮了。
我们马上进入实操:你要在 CodeBuddy 的 Plan 模式里输入一段提示词,让 AI 帮你完成 “用户点击加入购物车” 这个功能。
结合我们刚刚梳理的清单,在这个提示词里,你会如何向 AI 描述前端按钮的组件类型、接口响应的优先级,以及数据最终的落库策略?
为了让你在项目中能清晰地控盘,我帮你把你刚才的思路,整理成了你可以直接发给团队的标准交付清单要求:
交付物 1:微服务全局架构图 (Microservices Topology)
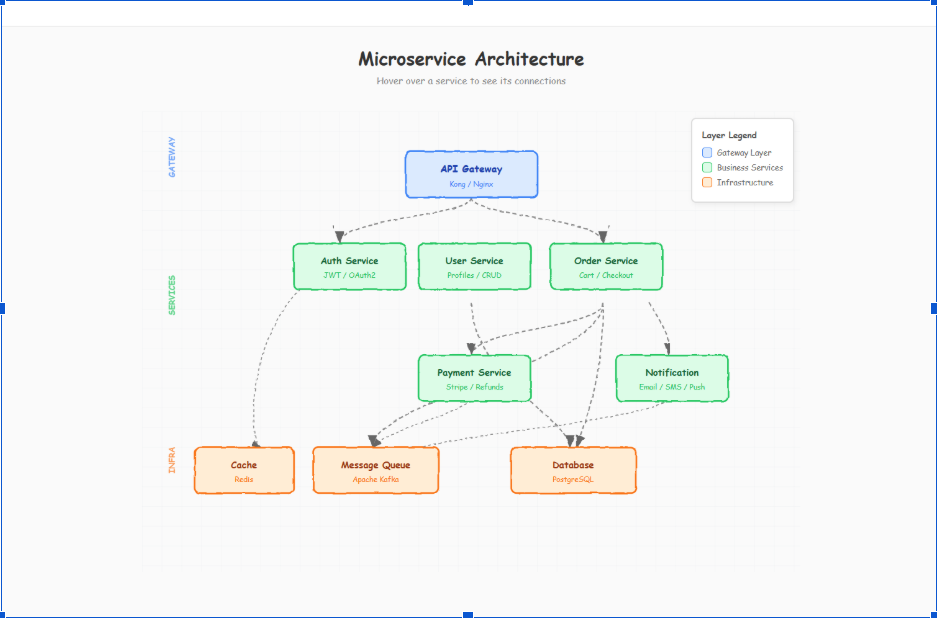
你要求团队必须先画出这张图,确认所有组件都在正确的位置上。这也是你心中应该建立的系统全貌:
📱 前端呈现层: Next.js (SSR 服务端渲染 + 客户端组件交互)。
🚦 统一网关 (API Gateway): 所有前端请求的入口,负责路由分发和基础鉴权。
⚙️ 微服务集群:
购物车服务 (Cart Service): 专为高并发设计,连接 Redis。
订单/支付服务 (Payment Service): 专为高安全设计,直连主数据库。
🗄️ 存储与缓冲层:
PostgreSQL: 核心永久档案库。
Redis: 高速内存便利贴。
消息队列 (MQ - 如 RabbitMQ/Kafka): “快递传送带”。当高并发涌入时,或者需要异步落库时,把任务扔到传送带上排队,防止把数据库冲垮。
交付物 2:核心业务的数据流转时序 (Data Flow Logic)
你刚才完美地拆分了两种不同业务级别的数据处理逻辑。你需要团队在设计文档中明确写出这两种流转路径:
路径 A:购物车添加/删除(追求极速响应)
策略: 异步落库 (Write-Back)
流转逻辑:
用户点击“加入购物车”。
【购物车服务】拦截请求,直接修改 Redis (便利贴) 里的购物车数据。
立刻向前端返回 {"status": "success"},用户界面瞬间更新,体验丝滑。
同时,后端把这个动作打包成一个消息,扔到 消息队列 (MQ 传送带) 上。
后台的工人(消费者程序)慢慢从传送带上拿下消息,在闲暇时更新到 PostgreSQL (永久档案库)。
路径 B:最终支付生成订单(追求绝对安全)
策略: 旁路缓存 (Cache Aside)
流转逻辑:
用户点击“确认支付”。
【支付服务】接管请求,绕过 Redis,直接开启 PostgreSQL 的数据库事务 (Transaction)。
在 Postgres 中扣减余额、生成订单,确认 100% 落盘安全。
数据库写入成功后,后端发送指令去删除或更新 Redis 中对应的旧缓存。
最后再给前端返回支付成功的响应。如果中间任何一步断电,数据库事务会回滚,一分钱都不会少。
把控技术时间的最后一步:
现在,架构蓝图和逻辑都对齐了。但在他们打开 CodeBuddy 开始生成这成百上千行的微服务代码之前,为了防止前端工程师(或生成前端代码的 AI)因为后端接口没写完而干等着,从而浪费宝贵的项目时间……
作为主导者,你应该要求后端在写具体逻辑代码之前,先输出一份什么文件,才能让前端不依赖后端,立刻开始带数据的 UI 联调?
答案:后端应该要出一个API的标准文档, 要求后端先出 API 文档,是打破“前端干等后端”死局的核心,在工程管理上这被称为 “API First(接口优先)” 开发模式。
在现代全栈开发和 Vibe Coding 的语境下,你绝对不需要让后端去手写 Word 或 Wiki 文档。以下是目前最主流、且 AI 识别率最高的自动化工具:
1. Swagger / OpenAPI (全球绝对标准)
它是啥: 几乎所有现代后端框架的标配。它能直接读取后端的代码结构,自动生成一个可以在网页上查看、甚至直接点击测试的交互式文档。
Vibe Coding 杀手锏: 前面我们讨论后端技术栈时提到了 Python 的 FastAPI。它的强大之处在于能 完全自动生成 Swagger 文档。只要后端把刚才说的 Schema(数据结构)定义好,代码一跑,文档瞬间生成,零额外工作量。
AI 联动: CodeBuddy 等 AI 工具可以直接读取 OpenAPI 导出的 JSON 描述文件,然后一键生成 前端所需的所有数据类型(TypeScript Interfaces)和网络请求代码,彻底消灭手动对接的误差。
2. Apifox (国内团队的“全能神器”)
它是啥: 它可以被理解为 Swagger + Postman + Mock 的结合体,目前在国内极其流行。
为什么 PM 和前端极度依赖它: 界面全中文且对非技术人员极度友好。最关键的是它的 云端 Mock 功能。后端只要在 Apifox 里把接口的“长相”定义好(比如返回一个标题和价格),Apifox 就会自动生成一个假的 URL 链接,前端调用这个链接就能拿到逼真的假数据(Mock Data),立刻开始写 UI 逻辑。
3. Postman
它是啥: 老牌经典的接口调试工具。
适用场景: 虽然它也能生成和分享文档,但它更偏向于“测试”而不是“定义”。目前很多新项目在文档和 Mock 环节会优先选择 Apifox。
作为 PM 的控场话术:
在项目进入开发阶段的第一天,你可以直接对团队下达这样的指令:“在正式写业务逻辑前,我需要你们先输出 Swagger 链接 或建好 Apifox 项目。前端直接基于 Mock 数据开工,我不希望看到前端因为等后端接口而停工的情况。”
现在,前端拿着 Apifox 的假数据去画 UI 和写交互了,后端也按照蓝图去写数据库和核心逻辑了。两边并行,时间确实省下来了。
但是,当两边各自完成,准备把真实的后端和真实的前端“拼”在一起(也就是进入前后端联调阶段)时,经常会爆发巨大的冲突和延期。结合我们刚才讨论的 API 的 5 步走逻辑,你觉得这种冲突最有可能出在哪个环节?
答:在前后端联调时,最容易爆发冲突和延期的环节通常是 数据校验(Validation) 和 数据响应(Response)。
简单来说,就是前端和后端对数据格式的契约没有对齐。比如:
🛒 前端以为“商品价格”是一个数字(如 99),打算直接用来做加减法;
⚙️ 后端却返回了一个字符串(如 "99"),或者干脆因为没查到数据返回了一个空值(null)。
当前端拿到意料之外的数据格式时,界面就会瞬间白屏崩溃 💥。这就是为什么我们强调要先出 API 文档——为了提前锁死数据的“长相”。为了让你更直观地感受到这种“前后端不一致”是如何摧毁一个项目的,我们做了一个「API 联调冲突模拟器」。
你可以亲自扮演后端,试着修改返回的数据格式,看看前端界面会发生什么。
玩过这个模拟器后,你会发现很多技术延期其实不是因为代码难写,而是因为沟通错位。
最后总结:
在项目进入开发阶段的第一天,你可以直接对团队下达这样的指令:“在正式写业务逻辑前,我需要你们先输出 Swagger 链接 或建好 Apifox 项目。
前端直接基于 Mock 数据开工,我不希望看到前端因为等后端接口而停工的情况。”
现在,前端拿着 Apifox 的假数据去画 UI 和写交互了,后端也按照蓝图去写数据库和核心逻辑了。两边并行,时间确实省下来了。
但是,当两边各自完成,准备把真实的后端和真实的前端“拼”在一起(也就是进入前后端联调阶段)时,经常会爆发巨大的冲突和延期。结合我们刚才讨论的 API 的 5 步走逻辑,你觉得这种冲突最有可能出在哪个环节?
回答:在前后端联调时,最容易爆发冲突和延期的环节通常是 数据校验(Validation) 和 数据响应(Response)。
简单来说,就是前端和后端对数据格式的契约没有对齐。比如:
🛒 前端以为“商品价格”是一个数字(如 99),打算直接用来做加减法;
⚙️ 后端却返回了一个字符串(如 "99"),或者干脆因为没查到数据返回了一个空值(null)。
当前端拿到意料之外的数据格式时,界面就会瞬间白屏崩溃 💥。这就是为什么我们强调要先出 API 文档——为了提前锁死数据的“长相”。
为了让你更直观地感受到这种“前后端不一致”是如何摧毁一个项目的,我们做了一个「API 联调冲突模拟器」。你可以亲自扮演后端,试着修改返回的数据格式,看看前端界面会发生什么。
玩过这个模拟器后,你会发现很多技术延期其实不是因为代码难写,而是因为沟通错位。
既然我们知道了数据格式对齐的重要性,在实际的项目管理中,当技术合伙人向你汇报“前端界面已经画好了,后端接口也写完了,我们明天开始联调”时,你觉得你可以追问一个什么问题,来确保他们明天不会因为数据格式问题而吵架?
为了做到万无一失,作为把控全局的架构师,你可以把这个问题升级成一个“防呆(防错)检查”:
“前端,你的数据类型定义(TypeScript Interfaces),是直接通过工具从 Swagger/Apifox 一键自动生成的,还是你自己对着文档手敲出来的?”
如果他回答是“手敲的”,那你就可以预见明天联调肯定要扯皮。如果是“自动生成的”,那就基本稳了。
这就是 Vibe Coding 的魅力所在: 你甚至不需要每次都口头问。你只需要在项目的 .codebuddy/rules 文件里写下一条铁律:
“前端严禁手动定义 API 数据结构,必须读取 Swagger 的 JSON 文件由 AI 或工具自动生成。”
这样,CodeBuddy 在帮你或你的团队写代码时,就会强制遵守这个标准。
到这里,我们已经把你最初提问的三大核心模块全部跑通了:
🏗️ 技术栈黑话: 掌握了 Next.js(门面)、FastAPI(大脑)、Prisma(翻译官)、Postgres(档案库)、Redis(便利贴)。
🔄 数据流转架构: 明白了在追求极致速度(购物车)和绝对安全(支付扣款)时,数据落库的不同策略。
⏱️ 时间与团队控盘: 知道了要在写代码前卡住“系统架构图”和“API 文档”这两个关键检查点,并用 Mock 数据让前后端并行。
带着这套认知,你已经完全具备了筛选优质技术伙伴、并掌控全局进度的能力。