从一个家庭药柜到公网 AI 问诊:AI token 深解析与宝塔部署全流程实录
项目地址:zyf.seguzhixue.cn(家庭中药柜索引 + AI 倪师问诊,Flask + SQLite + 原生 JS,单容器 Docker 部署)。这篇文章把从「一张截图里的药柜表」到「公网可访问的 AI 问诊站」全过程里,值得复用的关键动作沉淀下来——AI 上下文里每一类 token 从哪来、怎么算、怎么裁、参数怎么配,55 张图怎么不花一分钱跑通,宝塔 Docker 从零到 https 的每一步、反向代理哪里最容易踩坑,以及更新与回滚的完整闭环。
一、项目长什么样
两个标签页,全部功能围绕「家里真实的药柜」:
- 药柜索引——187 味药材按七个柜层(望岳 / 含章 / 厚德 / 知味 / 藏珍 / 承露 / 拾遗)登记,每味带实拍图、性味归经、功效、位置、注意事项;另含食补食材、18 首经方、55 首自制调养方、安全协议。
- AI 倪师问诊——四个内置技能(症状辨析 / 配方建议 / 经方与专栏方速查 / 药材知识),把整柜药材清单压进 system prompt,问「昨晚淋雨受凉鼻塞怕风」它回答用的每味药都标着「第 X 层」。
技术栈刻意保守:Flask 3 + SQLite + 无构建步骤的原生 JS,一个 252KB 的数据库文件 + 62MB 图片目录就是全部状态,Docker 单容器可跑。选这套不是为了怀旧,而是家庭工具的第一需求是十年后还能跑。
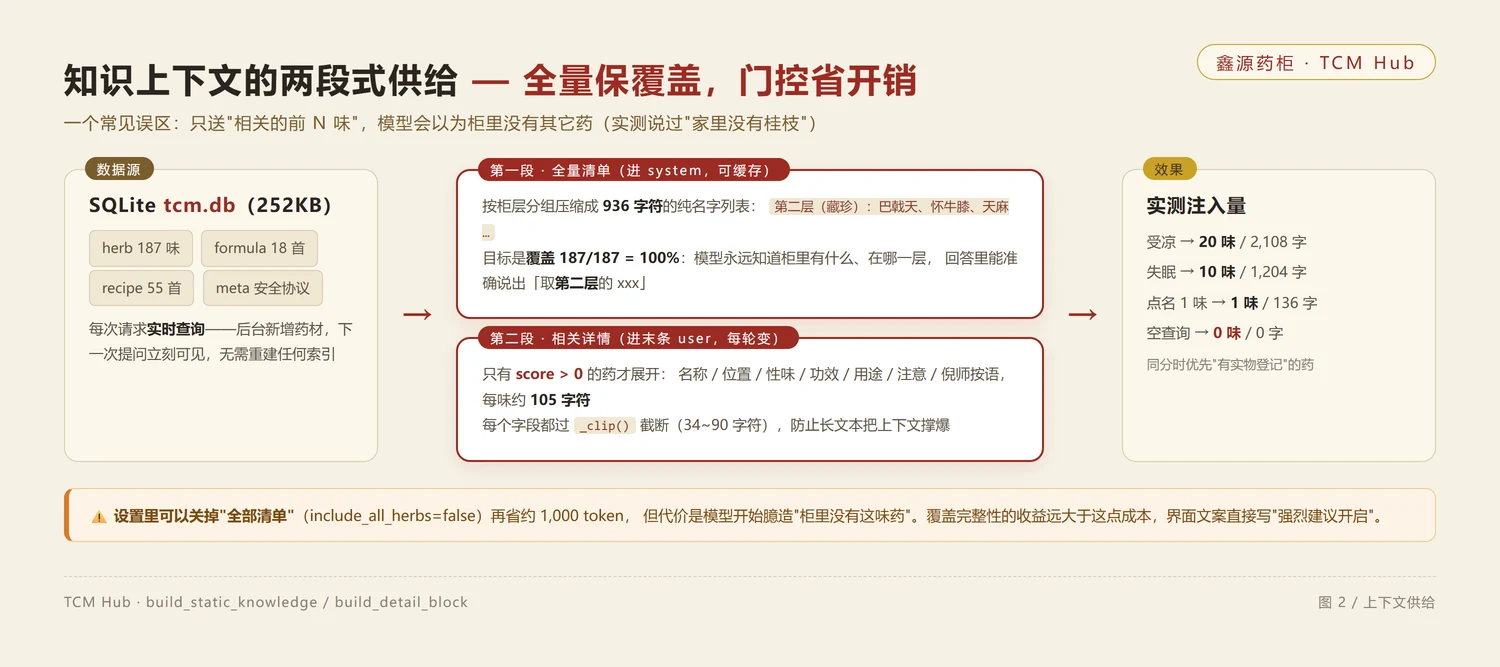
支撑 AI 问诊的知识供给是两级结构:全量清单常驻 system 前缀(便宜、稳定、可缓存),重量级详情按需注入(贵、易变、必须门控):
二、AI token 深解析:从计算方式到省钱配置
这一章把 AI 问诊的 token 账本彻底摊开:每一类 token 从哪来、怎么统计、怎么裁剪、参数怎么配、省了多少、代价是什么。所有数字都来自项目里的实测脚本 verify_ai_context.py 和真实 API 响应,不是估算。
2.1 token 是怎么算的:usage 字段透传成「账单行」
DeepSeek 的 OpenAI 兼容接口在每次响应里都带 usage 对象。后端原样透传给前端:
res = call_api(ai_cfg, messages)
return {"content": res["content"], "usage": res.get("usage"),
        "context_chars": ..., "detail_count": ...}
前端在每条回复气泡下方渲染一行用量小字:
// templates/index.html
const u = m.usage && (m.usage.prompt_tokens || m.usage.total_tokens);
if(u) bits.push(`输入 <b>${m.usage.prompt_tokens||0}</b> / 输出 <b>${m.usage.completion_tokens||0}</b> tokens · 缓存命中 <b>${m.usage.prompt_cache_hit_tokens}</b>`);
这行小字就是「账单」:
prompt_tokens——本次输入总量(system + 全部历史 + 本轮提问 + 动态详情块);completion_tokens——本次输出总量(推理模型的思考部分也算在这里);prompt_cache_hit_tokens——输入中命中前缀缓存、按 1/10 价计费的部分。
2.2 一次提问的上下文结构:谁在缓存里,谁每轮都变
每次发给模型的消息分三段,缓存属性完全不同:
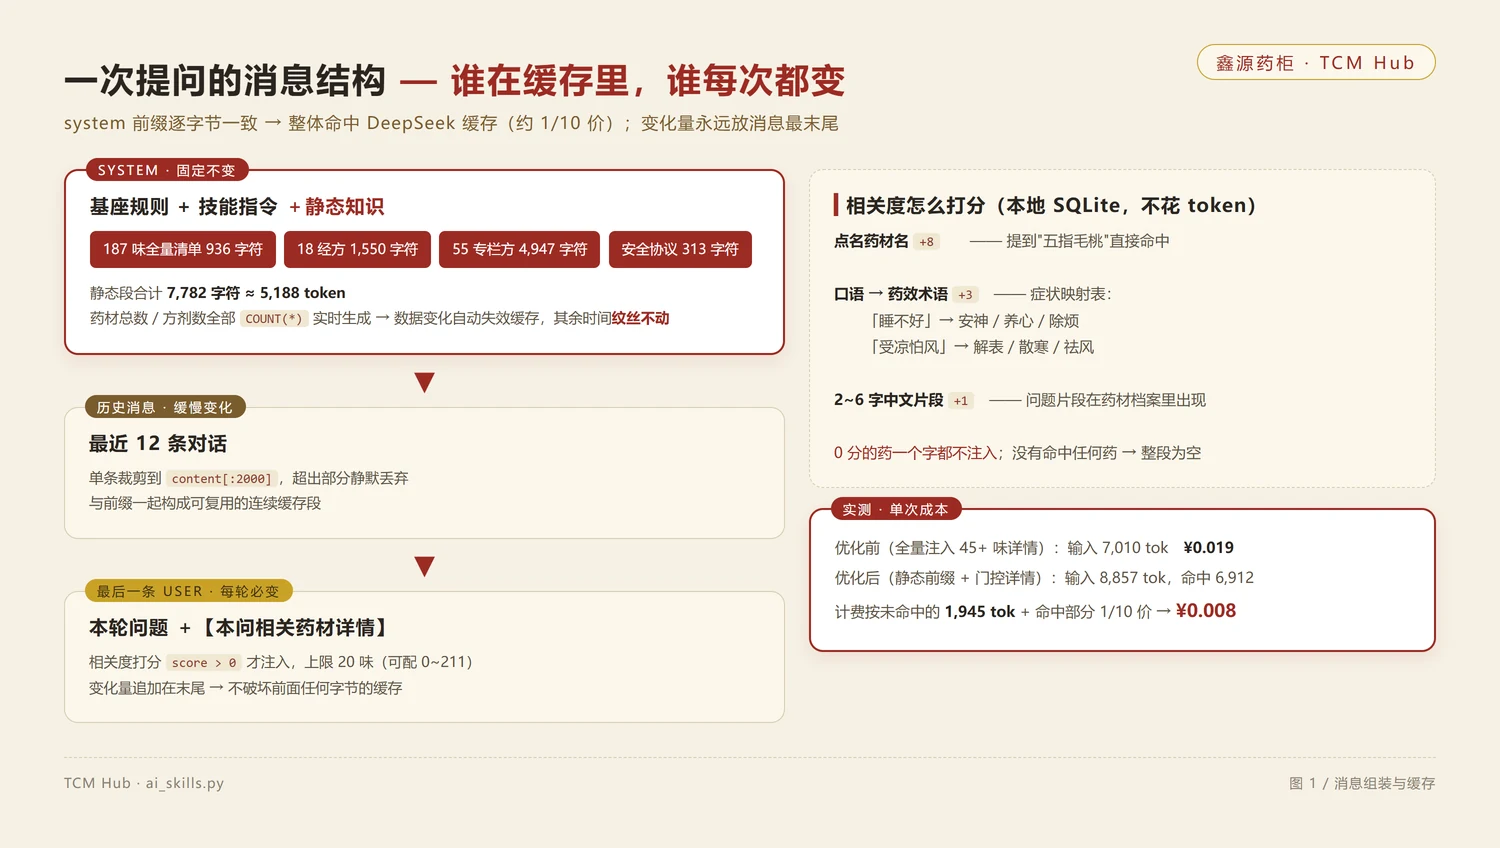
① system 前缀:静态知识,7,782 字符 ≈ 5,188 token,纹丝不动
| 组成 | 字符数 | 说明 |
|---|---|---|
| 【本柜药材全量清单】 | 936 | 187 味,一味一行「名称 · 柜层 · 一句话功效」,覆盖率 100%(脚本逐条断言) |
| 【经典经方速查】 | 1,550 | 18 首经方:方名 + 组成 + 主治一行 |
| 【倪师专栏调养方】 | 4,947 | 55 首自制调养方:方名 + 组成 + 适应症 |
| 【安全协议】 | 313 | 细辛小毒、附子先煎、急重症就医等红线 |
| 基座规则 + 4 技能说明 | — | 辨证流程、回答必须标注柜层、技能切换指令 |
静态段合计 7,782 字符 ≈ 5,188 token。有个细节:规则文本里的「药材总数 / 方剂数」是从数据库实时 COUNT 出来写进去的——改了数据,前缀自动变化、缓存自动失效重建;正常情况下前缀逐字节一致(脚本对 6 种不同提问构建 messages,断言 system 段完全相同)。
② 历史消息:只带最近 12 条,单条截断 2,000 字符
build_messages() 里两行关键代码:
for m in user_messages[-12:]:              # 只带最近 12 条
    msgs.append({"role": role, "content": m["content"][:2000]})
两个限制叠加:超过 12 条的旧对话整体丢弃;单条消息超过 2,000 字符的部分静默截断。对家庭问诊场景,12 条足够覆盖「追问症状 → 出方 → 追问禁忌」的完整往返,再多就是纯付钱不复述。历史消息缓慢增长,与静态前缀一起构成可复用的连续缓存段。
③ 最后一条 user 消息:本轮提问 + 动态详情块
相关药材的详情不进 system,而是打分后拼在最后一条用户消息末尾——每轮只有这里在变,且只追加不修改(这是缓存友好的关键,见 2.4)。
2.3 相关度门控:score>0 才注入,0 分一个字都不给
动态详情块由 build_detail_block() 生成:对全柜 187 味药逐一打分 → 只取 score>0 → 排序截断 → 拼块。打分函数三层:
def _score(query, blob, name, terms=()):
    if name in query: return 8          # ① 提问点名了药材名,直接命中
    s = 0
    for t in terms:
        if t in query: s += 3           # ② 症状词翻译成功效术语后命中
    for i in range(2, 7):               # ③ 2~6 字中文片段落在档案里
        for pos in range(len(query)-i+1):
            if query[pos:pos+i] in blob: s += 1
return s- +8:提问里点名了药材名(「五指毛桃怎么泡」)——精准命中,一票定音;
- +3:口语症状经
SYMPTOM_MAP翻译成功效术语后命中(「睡不好」→ 安神 / 养心 / 除烦,「淋雨受凉」→ 解表 / 散寒 / 祛风)——这张翻译表是口语和档案用语之间的桥; - +1:2~6 字中文片段在药材档案文本里出现——兜底,防翻译表没覆盖的表述。
score=0 的药一个字都不注入;score>0 的按分数排序(同分时柜里实际有这味药的排前),取前 herb_detail_limit 味。实测四种典型提问:
| 提问 | 注入详情 | 动态块大小 | Top 命中 |
|---|---|---|---|
| 「昨晚淋雨受凉」 | 20 味(触顶) | 2,108 字符 | 辽细辛 / 公丁香 / 干紫苏 / 白芷 / 防风 |
| 「失眠」 | 10 味 | 1,204 字符 | 丹参 / 五味子 / 百合 |
| 点名一味冷门药 | 1 味 | 136 字符 | 五指毛桃(+8 精准命中) |
| 空查询 | 0 味 | 0 字符 | 整段为空,不注入 |
每味注入的药还有字段级截断 _clip():性味 34 / 功效 44 / 用法 40 / 注意 34 / 来源 24 / 经典引文 90 / 含义 70 字符,超长加省略号。187 味全量详情约 6 万字符,门控 + 截断后单轮最多 ~2,100 字符——用 3.5% 的体积拿到 100% 的相关性。
2.4 prefix cache:逐字节一致的前缀,97% 命中率
DeepSeek 对「逐字节相同的前缀」自动按 64-token 块做上下文缓存,命中部分按约 1/10 价计费。所以上下文里的易变内容必须全部放消息末尾:
实测三组数字:
- 冷启动:输入 7,010 tok,缓存命中 0——这是唯一一次全价;
- 热请求:输入 7,010 tok,命中 6,784——命中率 97%,单次成本 ¥0.019 → ¥0.008;
- 端到端(带 20 味门控详情):输入 8,857 tok,命中 6,912——详情块追加在末尾,丝毫不破坏前缀缓存。
verify_ai_context.py 对 6 种提问分别构建 messages,断言 system 段逐字节一致;e2e 测试用真实 API 跑,断言 prompt_cache_hit_tokens > 5000。16 项断言跑一遍五分钟,比「感觉它变聪明了」靠谱得多。2.5 参数配置:每个旋钮管什么、默认多少、怎么调
全部旋钮集中在 data/config.json 的 ai 节点,后端每次请求热读取,改完即时生效、无需重启(也可在页面「设置 → AI 设置」里改):
| 参数 | 当前值 | 范围 / 约束 | 管什么 |
|---|---|---|---|
model | deepseek-reasoner | — | chat 与 reasoner 缓存池不共享,切换模型 = 冷启动一次 |
max_tokens | 3000 | 256~8192(保存时钳制,默认 2048) | 单次输出上限,推理模型的思考也吃这个额度 |
temperature | 0.3 | 0~2 | 越低越稳定。0.3 = 倾向复述档案而非自由发挥 |
herb_detail_limit | 20 | 0~211(保存时钳制) | 动态详情注入上限。0 = 完全不注入,最省 token |
include_all_herbs | true | 开关 | 清单进 system(936 字符)。关掉省 ~1,000 tok,但模型会虚构「家里没有桂枝」 |
show_reasoning | true | 开关 | 展示思考链。思考 token 照付输出价,关掉只是不显示、不省钱 |
requires_code | false | 开关 | false = 打开页面就能问;true = 先解锁才能问 |
max_tokens 最容易踩的坑:思考也吃额度
deepseek-reasoner 的思考过程消耗的也是 max_tokens 额度。实测设 600 时,思考就把额度用光,content 返回空字符串——前端只看到「回复为空」,还以为是模型坏了。判断方法很简单:completion_tokens 恰好等于 max_tokens 且 content 为空,就是思考吃光了额度,调大即可。所以默认给 2048 保底,当前设 3000;保存配置时后端钳制在 256~8192,防止填 0 导致永远空回复。
两个省钱旋钮的取舍
- herb_detail_limit 调小:省的是输入 token,代价是冷门药答不准——模型只看得到清单里的一行简介,说不出煎法禁忌。20 是相关性 / 成本的平衡点;
- include_all_herbs 关掉:省约 1,000 tok/次,代价是模型不知道柜里实际有什么,会一本正经地虚构「建议加桂枝,家里没有的话用肉桂代替」——对「用自己柜里的药开方」这个核心需求是致命伤。省的钱远不如造成的错误值钱,强烈建议保持开启。
2.6 成本账本:优化前后的每一分钱
| 项目 | 优化前(全量注入) | 优化后(前缀 + 门控) | 说明 |
|---|---|---|---|
| 输入构成 | 45+ 味全量详情,~6 万字符 | 静态前缀 7,782 + 门控详情 ≤2,100 字符 | 95% 与提问无关的详情不再付费 |
| 缓存命中 | 0(每次都全价) | 6,784 / 7,010(97%) | 前缀逐字节一致是前提 |
| 单次输入成本 | ¥0.019 | ¥0.008(-58%) | 未命中部分全价 + 命中部分 1/10 价 |
两条通用的省钱心法,脱离这个项目也成立:一是把稳定的放前面、易变的放后面(吃前缀缓存);二是「按需注入」替代「全量注入」(本地先做一轮免费的检索,只把相关的喂给模型——打分用的是 SQLite,一分钱 token 都不花)。
2.7 requires_code:开放与防刷之间一个开关
AI 问诊默认开放(false = 打开页面就能问,家人零门槛)。公网部署若担心 API 额度被刷:把 ai.requires_code 改成 true 即时生效,恢复「先解锁才能问」;或在宝塔「访问限制」给整站加 BasicAuth。写操作(增删药材、改配置)永远需要验证码,没有放松。
三、55 张方剂实物图:从“AI 示意图”到“看得清药材”
方剂卡片原本配的是 AI 示意图——抽象色块里根本认不出哪味是党参哪味是白术。重做方案:
- 统一风格出样张:俯拍平铺(flatlay)、亚麻布 + 陶碟、暖光、每味药材肉眼可辨——先出 3 张确认风格再批量,避免 55 张跑完才发现不对;
- 逐方生成:每首方一个输出目录(
batch/rNN/),按方剂组成写 prompt,中断可续跑; - 裁剪去水印:源图 1536×1024 带右下角“AI 生成”水印,直接裁到 1400×933(仍是 3:2)水印消失;
- WebP 落库:主图 q82(均 249KB)+ 600×400 缩略图(均 57KB),写 media + media_link 两张表,和药材图同一套机制;
- 懒加载:卡片内联用缩略图,点灯箱才取原图——55 张原图共 13.4MB,不懒加载首屏必卡。
cap,渲染读的是 caption,导致图注一直空白。这种“两头字段名不一致”的问题在快速迭代里最容易滋生——统一 schema 比事后打补丁划算。四、部署全流程:从零到 https 的可复现每一步
目标机:103.236.66.200(宝塔面板 :27665,Nginx 1.28,12 核 / 11.7G / 100G,已跑三个 PHP 站点,Docker 未装)。目标链路:
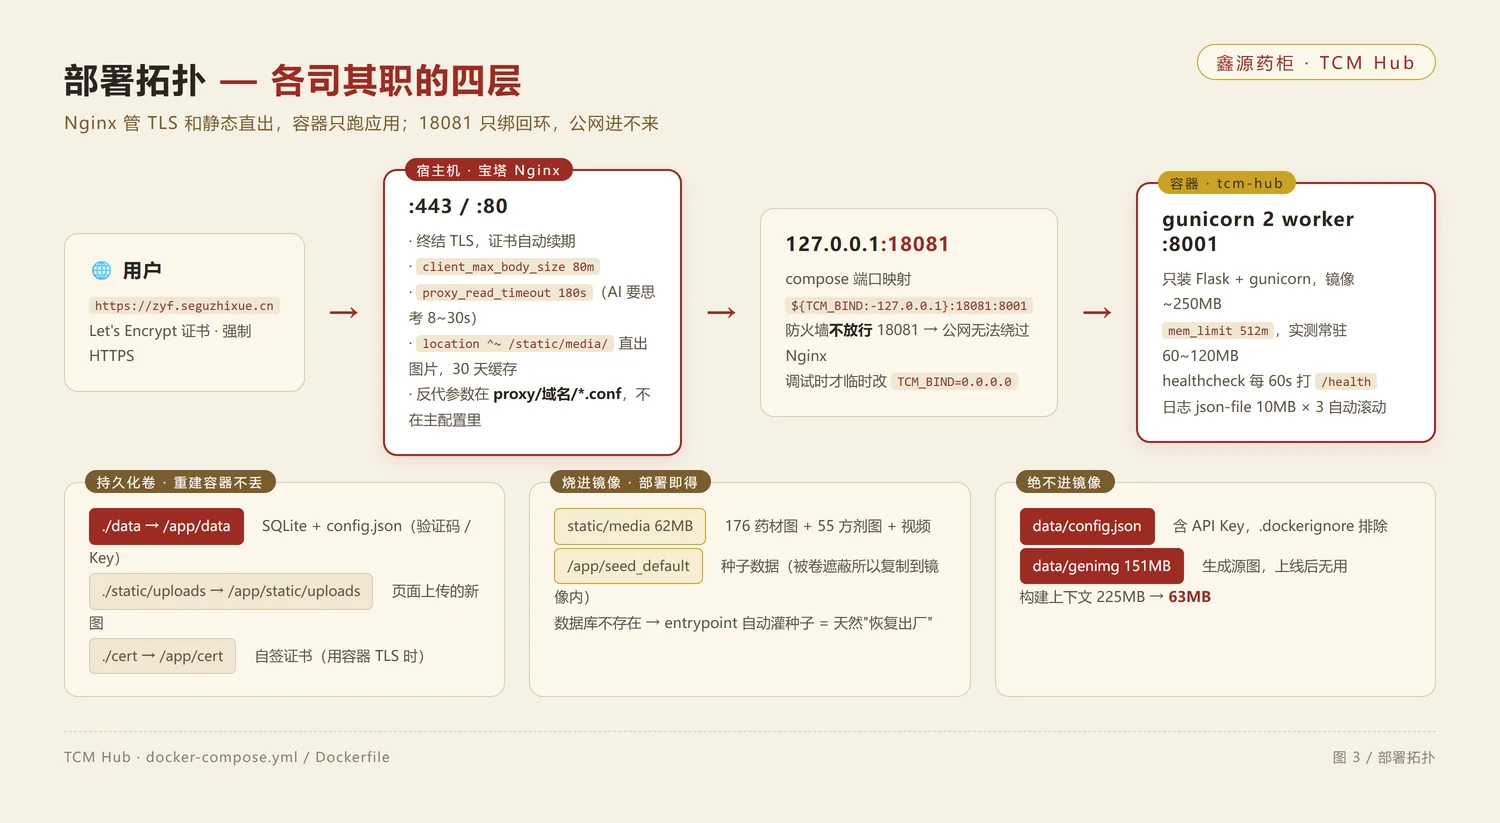
4.1 环境准备:DNS、端口、Docker
| 动作 | 操作位置 | 验证 |
|---|---|---|
加 A 记录 zyf → 103.236.66.200(TTL 600) | 域名解析管理页 | ping zyf.seguzhixue.cn 回显服务器 IP(1~10 分钟生效) |
| 放行 22 / 80 / 443 | 宝塔 → 安全 | Let's Encrypt HTTP-01 验证必须走 80 |
| 18081 不放行 | — | compose 已绑 127.0.0.1,公网到不了 |
| 磁盘 ≥ 1GB 空闲 | df -h / | 镜像 ~250MB + 数据 63MB |
装 Docker(宝塔 Docker 页显示未安装时):点「立即安装」,1~3 分钟装完 Docker CE + 基础组件,然后终端验证:
docker -v                 # Docker version 2x.x.x
docker compose version    # v2.x
第二条报错就补装 compose 插件:apt-get install -y docker-compose-plugin(Debian/Ubuntu)或 yum install -y docker-compose-plugin(CentOS)。镜像加速可选——本项目 compose 默认走 DaoCloud 代理拉 python:3.12-slim-bookworm,不配加速通常也能拉下来。
4.2 上传与依赖:宿主机零依赖,密钥不进镜像
运行时依赖只有 Python 3.12 + Flask 3 + gunicorn,全部打进镜像,宿主机不需要装任何东西。本地打包(在项目父目录):
python tcm-hub/scripts/pack_for_server.py
# 已生成 tcm-hub.tar.gz:526 文件 / 62.6MB
# 自动排除 data/genimg(151MB 生成源图)、backups、shots、testtmp、__pycache__
# 保留 tcm.db / config.json / seed / 全部 static/media
宝塔 → 文件 → 上传到 /www/wwwroot/ → 解压,然后权限与自检:
chown -R www:www /www/wwwroot/tcm-hub
chmod +x deploy.sh entrypoint.sh
ls -d static/media data/tcm.db data/config.json   # 三个都必须存在
环境变量与密钥
本项目真正的密钥只有一个:DeepSeek API Key,存在 data/config.json 的 ai.api_key。绝不进镜像——.dockerignore 明确排除,运行时由 ./data 卷挂载提供;泄露了就在 DeepSeek 控制台一键重置,再改本地文件重启容器。其余全部是可公开的环境变量(.env,deploy.sh 自动生成):
| 变量 | 默认 | 作用 |
|---|---|---|
TCM_HTTP_PORT | 18081 | 宿主机端口,Nginx 反代目标 |
TCM_BIND | 127.0.0.1 | 监听地址;改 0.0.0.0 才允许公网直连(仅调试) |
BASE_IMAGE | DaoCloud 代理 python:3.12-slim | 基础镜像源 |
PIP_INDEX_URL | 清华源 | 构建期 pip 源 |
TCM_TOKEN_MAX_AGE | 43200 | 编辑令牌有效期(12h) |
容器内部固定:TCM_DB_PATH=/app/data/tcm.db、TCM_CONFIG_PATH=/app/data/config.json、TCM_PORT=8001、TCM_WORKERS=2。
4.3 构建与启动:一条 deploy.sh
cd /www/wwwroot/tcm-hub
./deploy.sh
脚本依次做:检查 docker/compose → 生成 .env → 构建镜像 → 后台启动 → 轮询 /health 90 秒,失败自动吐最后 40 行日志。首次构建 3~6 分钟(拉基础镜像 + pip 装 Flask/gunicorn),预期结尾:
启动成功 ✅
  健康检查:{"db":"/app/data/tcm.db","herbs":187,"status":"ok"}
  监听:127.0.0.1:18081 → 容器 8001
/health 一身三职:Docker healthcheck 探针、部署验收探针、故障排查第一入口(容器活着吗?库里有多少味药?)。
Dockerfile 的两个关键取舍
种子数据放镜像内、不放挂载卷。./data 会遮蔽容器内同名目录,若种子放 /app/data/seed,首次启动挂载后必然建出空库。所以 Dockerfile 里:
RUN cp -r /app/data/seed /app/seed_default
ENV TCM_SEED_DIR=/app/seed_default
数据库不存在时 entrypoint 自动灌种子 = 天然「恢复出厂」;数据库存在则跳过 = 你的数据永不被覆盖。
构建上下文从 225MB 瘦到 63MB:.dockerignore 排掉生成源图(151MB)、备份、截图、临时测试库,加上排除含密钥的 config.json。构建上下文小一半,上传和构建都快一倍。
4.4 反向代理与 HTTPS:三个必改参数
宝塔 → 网站 → 添加站点(域名 zyf.seguzhixue.cn,PHP 版本选「纯静态」,不建 FTP / 不建数据库)。然后站点 → 设置 → 反向代理 → 添加:目标 URL 填 http://127.0.0.1:18081,发送域名 $host,缓存关闭。保存后改三个参数:
| 参数 | 默认 | 改成 | 为什么 |
|---|---|---|---|
proxy_read_timeout | 60s | 180s | AI 思考 8~30 秒,60s 必 504 |
client_max_body_size | 1m | 80m | 应用允许传 64MB 图,Nginx 先拦成 413 |
| 反代缓存 | — | 关闭 | 药材数据天天改,缓存导致看到旧内容 |
vhost/nginx/域名.conf)放 client_max_body_size 和静态直出;反代超时在另一个文件(vhost/nginx/proxy/域名/*.conf),界面入口是「反向代理 → 该条右侧配置文件」。改错文件是最常见的坑。#SSL-START、#REWRITE-START 这类成对注释块绝对不要删——宝塔靠它们定位插入点,删了以后申请证书 / 改伪静态会失败。证书与强制 HTTPS:顺序不能反
- 先确认容器活了:
curl http://127.0.0.1:18081/health返回 ok; - 配好反代后,浏览器开
http://zyf.seguzhixue.cn(先不加 s)能出页面——链路通了; - 站点 → SSL → Let's Encrypt → 文件验证 → 申请(10~30 秒)→ 开「强制 HTTPS」+ HTTP/2。
顺序反了的代价:证书签下来了页面却 502,排查方向全错。证书 90 天自动续期由宝塔计划任务负责,不用管。
图片直出(可选加速)
在站点主配置加一段,让 Nginx 直接读磁盘返回图片,不进容器:
location ^~ /static/media/ {
    alias /www/wwwroot/tcm-hub/static/media/;
    expires 30d;
    access_log off;
    add_header Cache-Control "public, max-age=2592000";
}
首屏图片响应快一截,容器也省心。注意 alias 结尾的 / 不能少。
4.5 上线验收清单
| # | 检查项 | 预期 |
|---|---|---|
| 1 | https://zyf.seguzhixue.cn | 正常出首页,锁标正常 |
| 2 | 概览数字 | 药材 187 / 方剂 55 / 经方 18 |
| 3 | 药材图墙 | 图片显示(说明 /static/media 通了) |
| 4 | AI 提问「昨晚淋雨受凉」 | 10~30 秒出答案,无 504,气泡下有用量行 |
| 5 | 上传一张药材图 | 不报 413 |
| 6 | 手机 4G 打开 | 首屏正常,无横向滚动 |
| 7 | curl -I https://zyf.seguzhixue.cn/health | 200 |
4.6 常见报错与排查
| 现象 | 根因 | 处理 |
|---|---|---|
| 502 Bad Gateway | 容器没起 / 端口不对 | docker compose ps + curl 127.0.0.1:18081/health |
| AI 提问 504 | Nginx 超时 60s | 反代配置 proxy_read_timeout 180s |
| 上传 413 | Nginx 默认 1m | 主配置 client_max_body_size 80m |
| 图全裂 | static/media 没传全 / 权限 | ls static/media/recipe | wc -l 应为 55;chown -R www:www |
| 概览数字是 0 | tcm.db 没传,容器灌了空种子 | 补传后 docker compose restart |
| 改代码不生效 | 只 restart 没 rebuild | docker compose up -d --build |
| AI 提问 403 | 宝塔 WAF 拦长 JSON | 站点白名单或关 WAF 再测 |
| 构建卡在拉镜像 | Docker Hub 慢 | 配镜像加速或改 .env 的 BASE_IMAGE |
| 容器反复重启 | 端口被占 / 库损坏 | docker compose logs --tail=50;ss -lntp | grep 18081 |
| 磁盘突然满 | 日志 / 备份堆积 | docker system df、docker image prune -f |
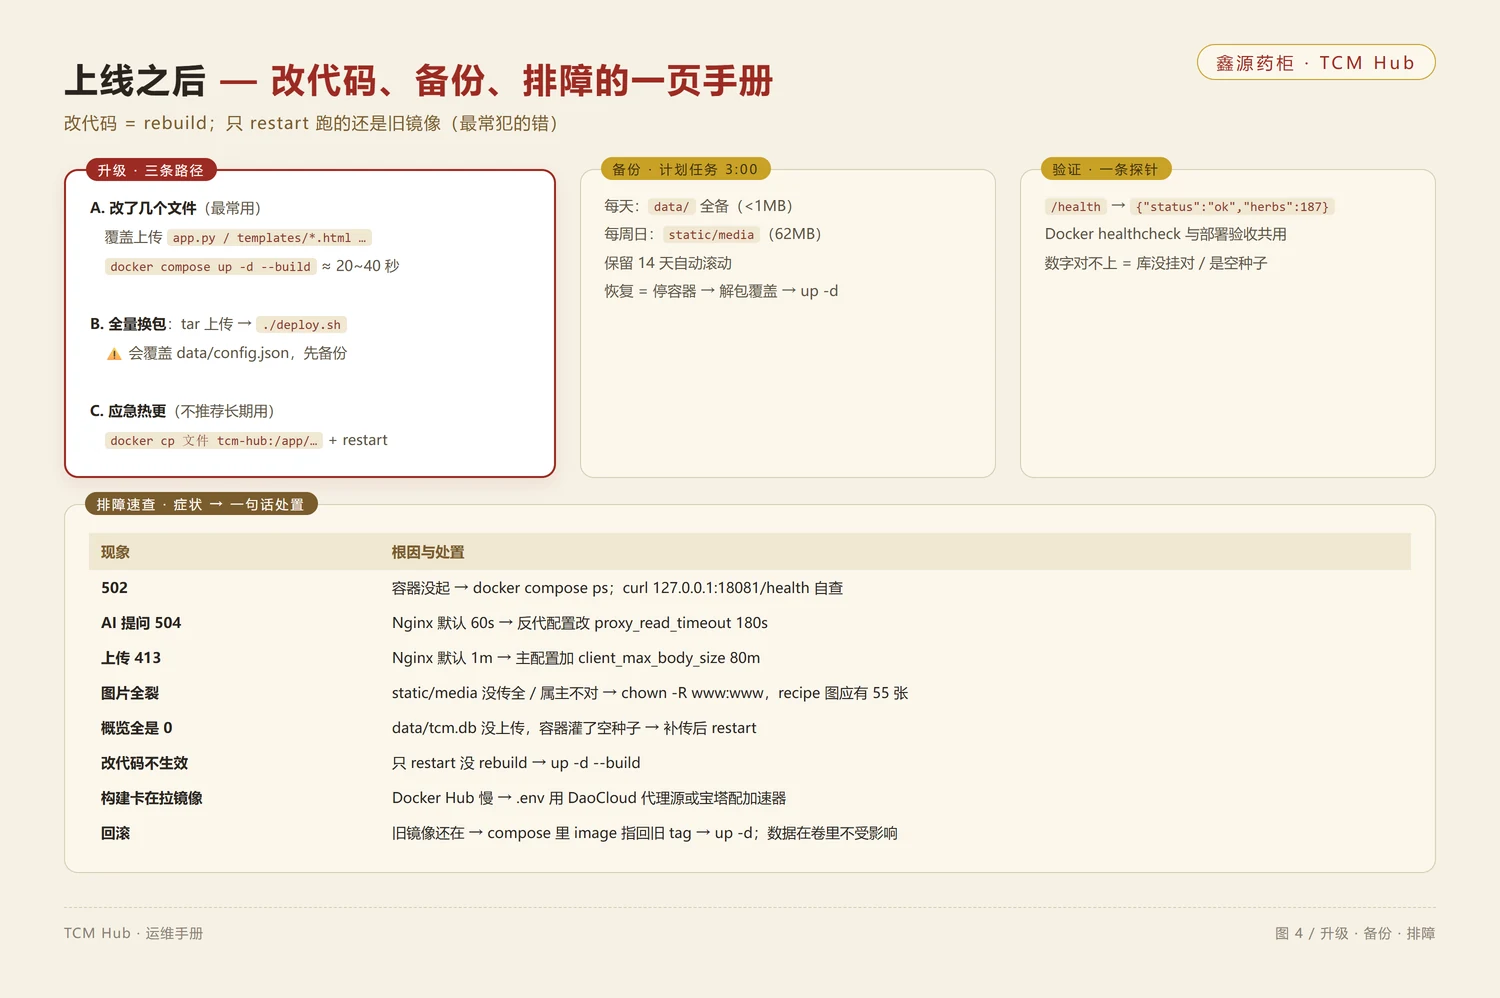
4.7 更新与回滚:两套命令走天下
改代码后同步——最快路径是宝塔文件管理器只覆盖改动的文件,然后:
cd /www/wwwroot/tcm-hub
docker compose up -d --build # 数据卷不动,数据不丢,20~40 秒注意:只 restart 不 rebuild 是无效的——代码是构建时 COPY 进镜像的,restart 跑的还是旧镜像。这是最常犯的错。pip 依赖层有缓存,只改代码时增量构建 20~40 秒。
备份策略(宝塔计划任务,每天 3 点):
tar czf /www/backup/tcm/data-$(date +%F).tar.gz -C /www/wwwroot/tcm-hub data
[ "$(date +%u)" = "7" ] && tar czf /www/backup/tcm/media-$(date +%F).tar.gz -C /www/wwwroot/tcm-hub static/media
find /www/backup/tcm -name '*.tar.gz' -mtime +14 -delete
数据库 + 配置天天备(<1MB),图片每周日备一次(62MB),留 14 天滚动。恢复三步:停容器 → 解开覆盖 data/ → docker compose up -d。
回滚两条路:有旧镜像就把 compose 的 image 指过去再 up -d(秒级);没有就恢复上一版代码后 up -d --build。数据层面的回滚用 data/backups/ 里的库文件直接覆盖。
恢复出厂 / 忘记验证码:删 data/config.json 重启回到默认验证码 1103(AI 设置会一起丢,慎用);删 data/tcm.db 重启自动重灌种子(增量数据全丢,先备份!)。
五、过程中的方法论沉淀
1. 每个结论都配一个验证脚本
这个项目累计 207 项自动断言:60 smoke + 117 UI + 16 AI 端到端 + 14 思考动效。每次改动跑一遍,五分钟,覆盖了所有曾经踩过的坑。比起「我相信没问题」,脚本会告诉你问题。
2. 陷阱都写在注释里
white-space: pre-wrap 会把模板字符串换行渲染成大片空白、or 兜底会吞掉合法的 0 值、Jinja 模板非 debug 模式缓存要手动刷新——这些坑第一次踩花了一小时,第二次靠注释三十秒绕过。给未来的自己写注释,是最高回报率的投资。
3. 配置驱动,不要硬编码
herb_detail_limit(0~211)、requires_code、max_tokens、模型选择——全部进 config.json 并热读取。「改配置即生效」的体验,会让调参这件事从「发版」降级成「刷新」。
4. 图片管线:生成 → 裁剪 → 压缩 → 懒加载,四步缺一不可
生成图带水印要裁、WebP q82 省三分之二体积、懒加载防首屏爆炸。中间任何一步省略,上线后都是肉眼可见的体验劣化。
最终状态:一个 62MB 的目录,tar 打包上传,一条 ./deploy.sh,三分钟后 https://zyf.seguzhixue.cn 可访问——187 味药材、55 首配实物图的方剂、四个倪师技能、0.008 元一次的 AI 问诊。
家庭工具的终极形态不是功能最多,而是十年后打开还能用、坏了五分钟内能重建。SQLite + 静态图 + 无状态容器,就是奔着这个标准去的。
—— 瑟谷智学 · 鑫源药柜项目实录,2026-11