记住只能复述,理解能够预言:真正的「懂」,是把世界压成一行
本文整理改写自视频《压缩即理解》:记住只能复述,理解能够预言。
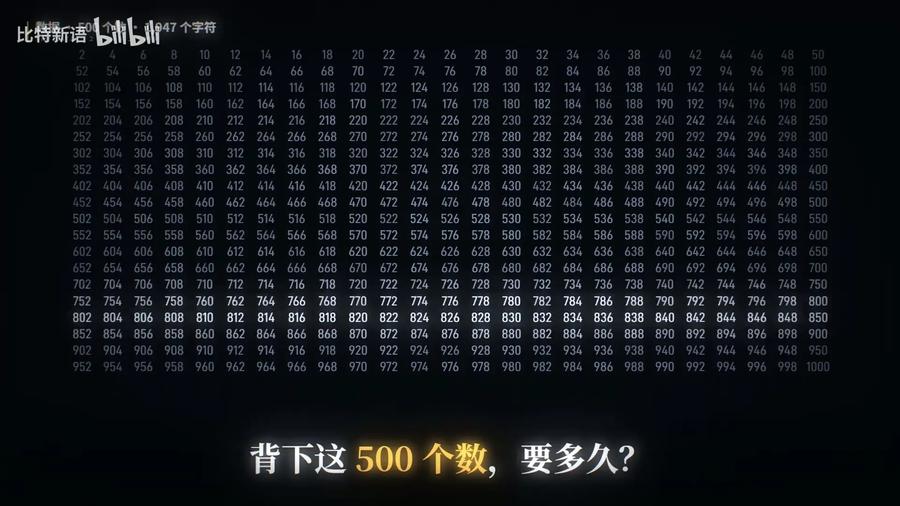
先做个小测试:把屏幕上的 500 个偶数(从 2 到 1000)背下来,你需要多长时间?
对比一下两种做法的代价:
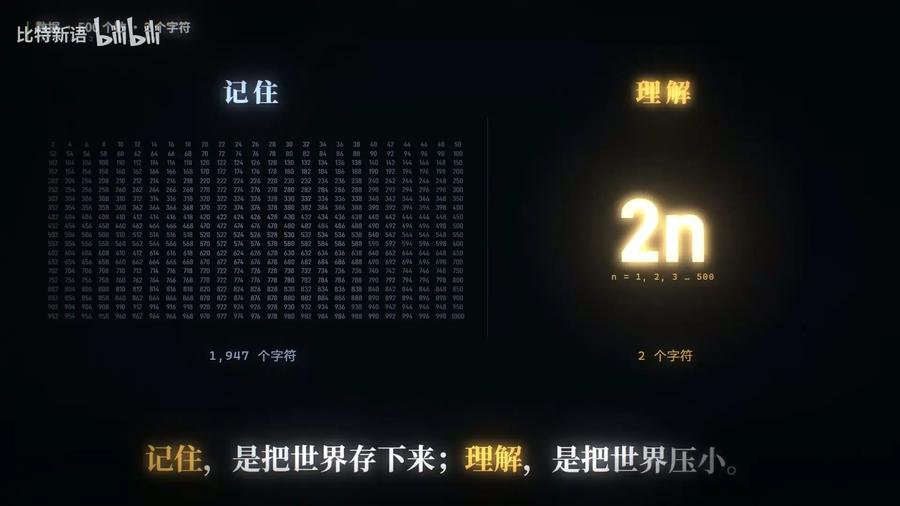
- 记住:完整复现这些数字,需要写下 1,947 个字符;
- 理解:找出规律,只需要一个公式
2n(n = 1, 2, 3 … 500),只用 2 个字符。
一句话点破:
记住,是把世界存下来;理解,是把世界压小。
这种"压缩"的思维方式,广泛存在于万事万物中——从星空、一只猫,到整个互联网。所有的"懂",在本质上都是同一个动作。这就是本文的主题:压缩即理解(Compression is Understanding)——把世界,压成一行。
一、记住只能复述,理解能够预言
怎么判断一个人是不是真懂?
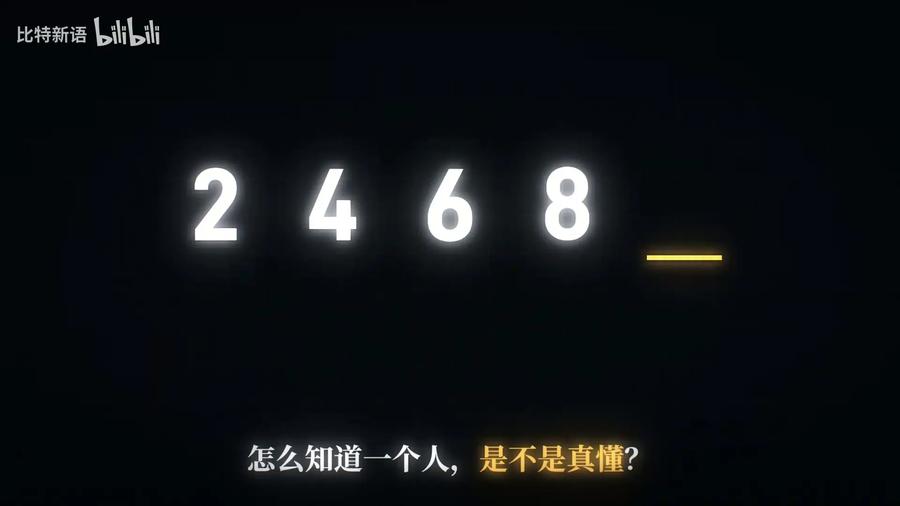
有个很直接的测试:给他看序列 2, 4, 6, 8,让他猜下一个。他能说出 10,说明他提取了背后的模式——而提取了模式,就能做出预测。
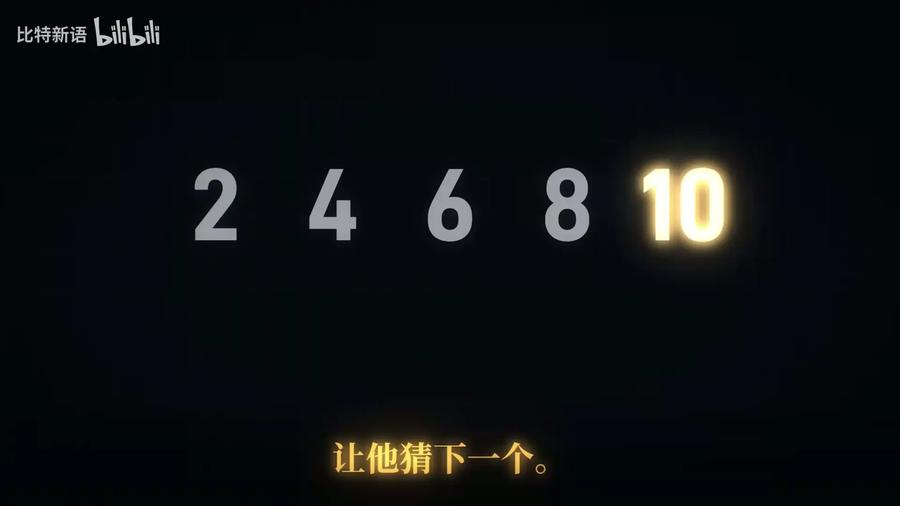
这正是"记住"和"理解"的分界线:记住只能复述已经见过的东西,理解却能预言从未见过的东西。
这个判断标准并不新。信息论之父香农当年估算英语信息熵时,用的就是同样的思路——让人猜字母。在句子 "THE ROOM WAS NOT VERY LIGHT A SMALL OBLONG" 中,受试者第一次就猜中了 42 个字母里的 29 个。
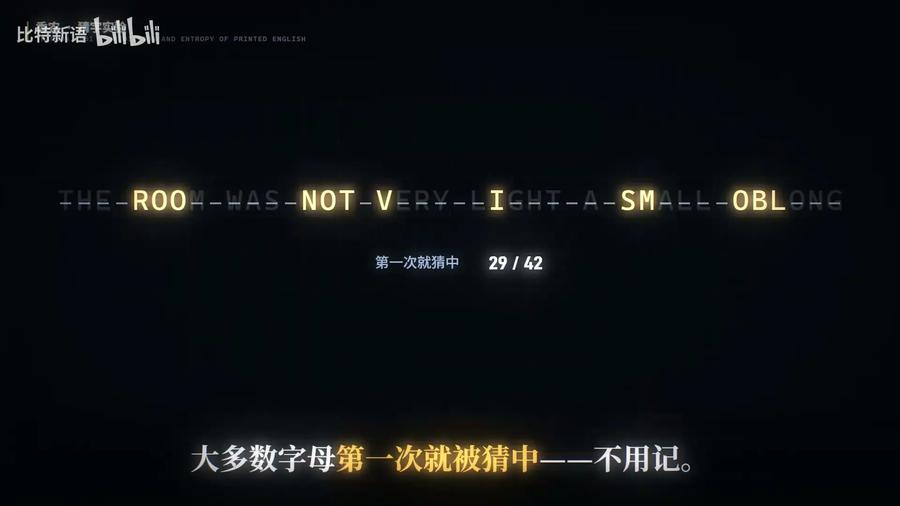
这说明什么?说明一旦理解了语言的规律,大多数字母第一次就能被猜中——大脑根本不需要把每个字母都存下来,因为信息早已被"压缩"了。
二、猜得越准,记得越少:信息量 = 惊讶的程度
香农的思路可以再往前推一步:一个东西携带多少信息,取决于它让你多意外。
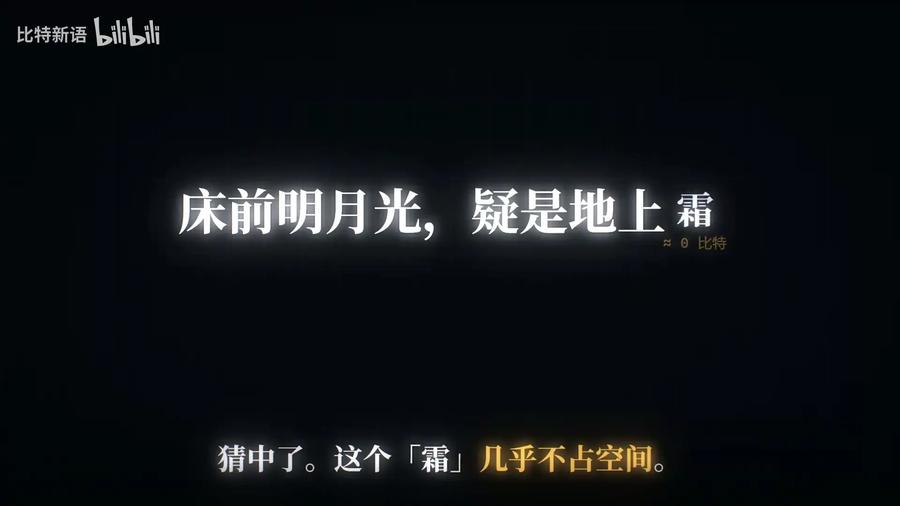
看这句诗:"床前明月光,疑是地上____。"
当一个模型已经高度确信答案是"霜"时,这个字几乎不携带任何信息,记下它的代价约等于 0 比特。
再看另一句:"我早上去超市买了一瓶牛奶和一只企鹅回家。"
前半句每个词的概率都很高,对应的比特数都很低;而"企鹅"突然出现,制造了一个巨大的尖峰——"意外!",约 44.8 比特。这才是真正需要记下来的部分。
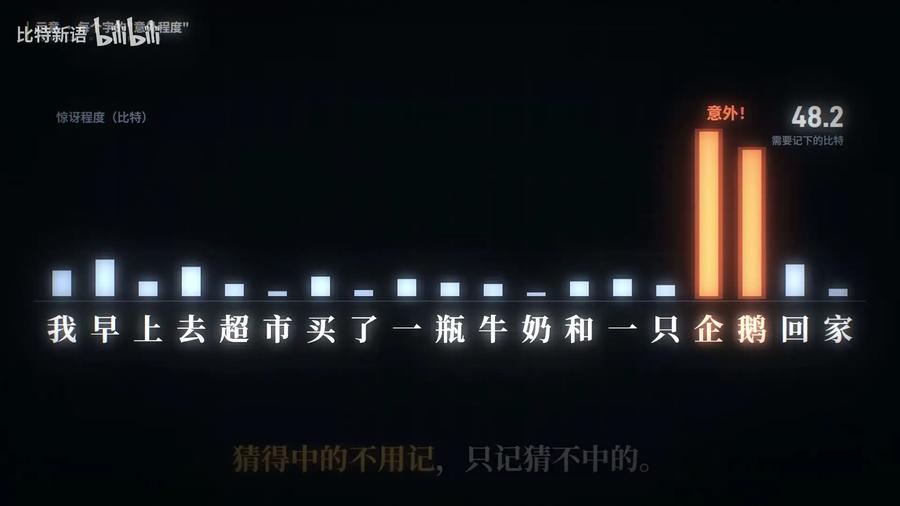
规律呼之欲出:猜得越准,需要记录的比特就越少,压缩率就越高。
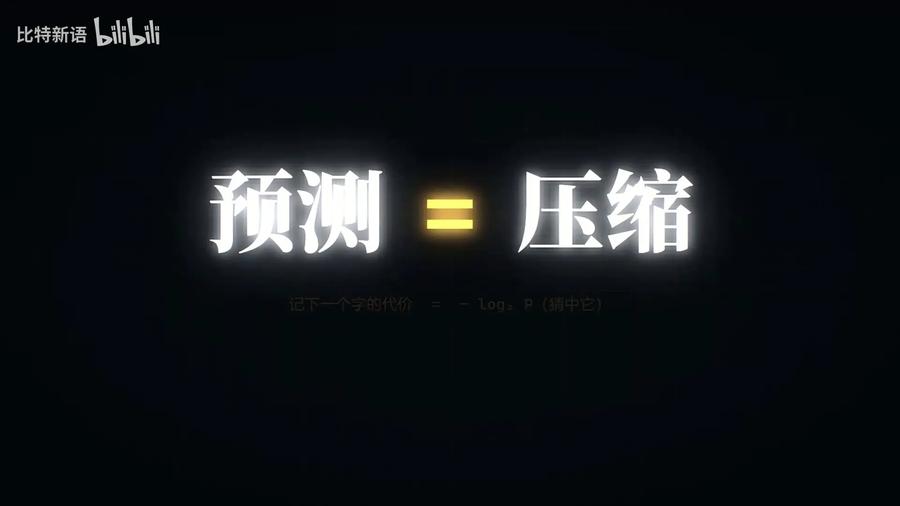
用信息论的公式写出来就是:
- 记下一个字的代价 = −log₂ P(猜中它的概率)
- 预测得越准(P 越大),代价越接近 0;越出人意料(P 越小),代价越大。
所以,预测 = 压缩。预测能力和压缩能力,是同一种能力的两张面孔。
三、科学史上最伟大的一次压缩:从乱麻到椭圆
这个原理不是纸上谈兵,它曾经实实在在地改写人类对宇宙的理解。
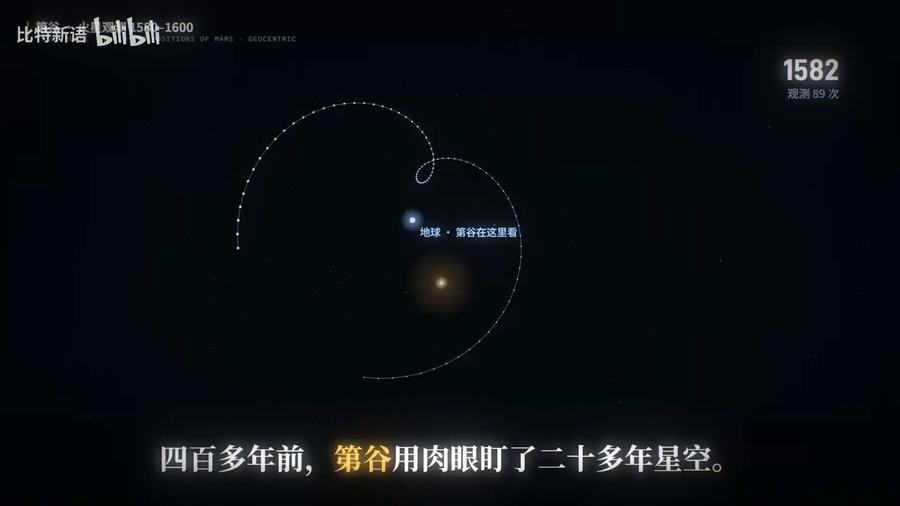
四百多年前,天文学家第谷用肉眼持续观测星空二十多年。从地球视角看,火星在天上画出的轨迹是这样的——1582 年时,已经观测了 130 次:
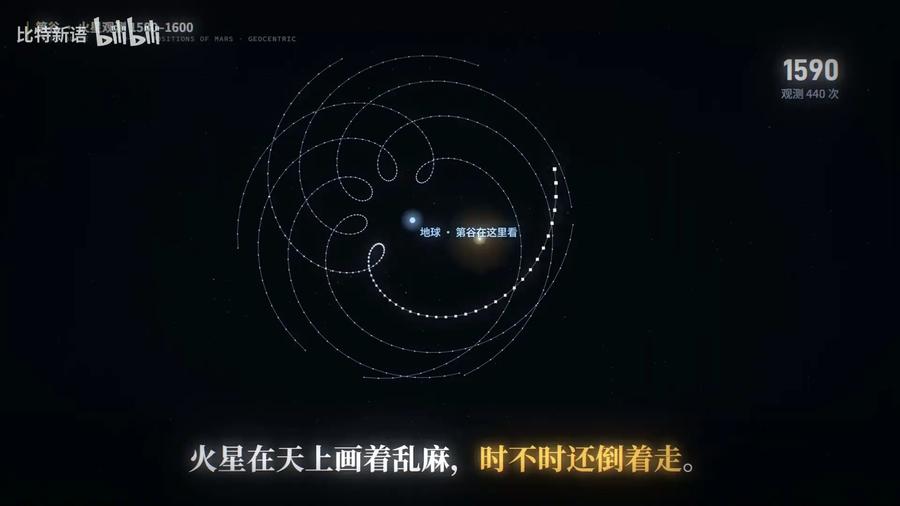
随着观测不断积累(1590 年,459 次),火星的轨迹变成了一团复杂的"乱麻",还时不时"逆行"——倒着走。只看这些数据,谁也看不出背后的规律。
到 1599 年,观测已达 815 次。第谷留下了一摞厚厚的数字表——逐日的火星方位角记录。数据很完整,但冗长到无法直接理解。
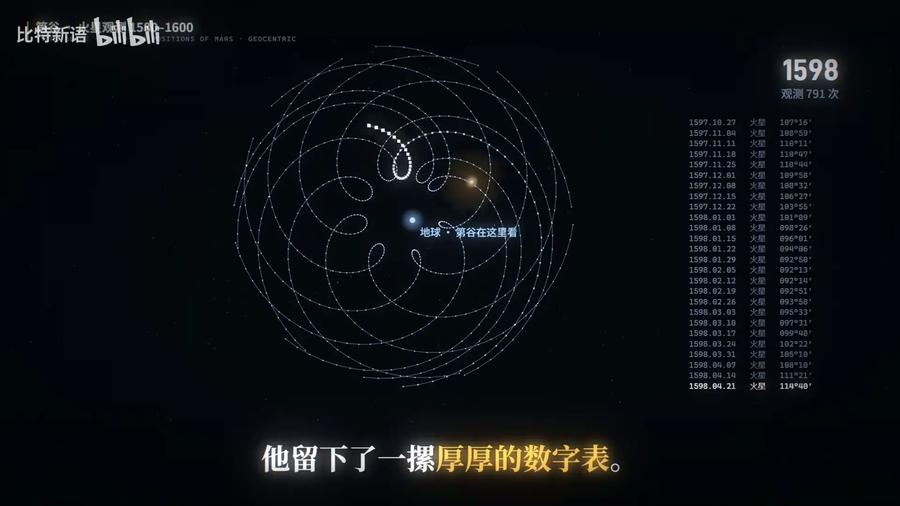
然后,开普勒换了个角度:站到太阳上看。
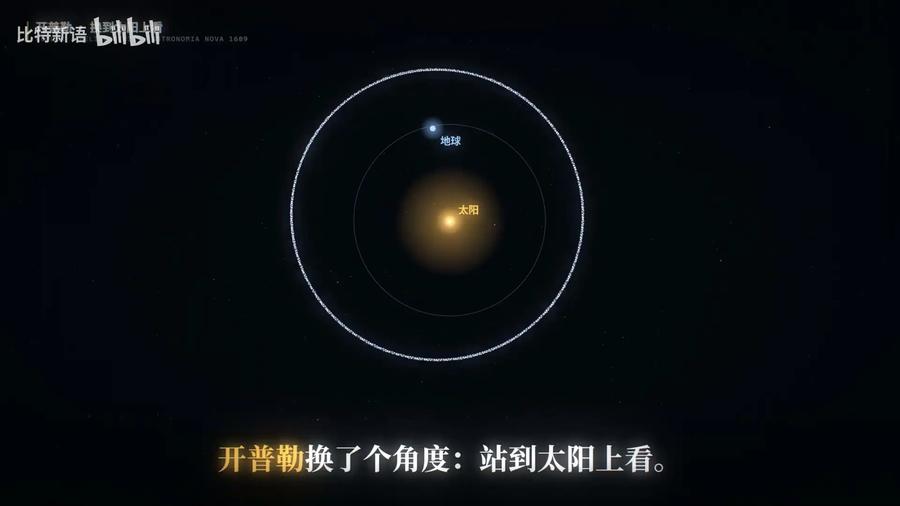
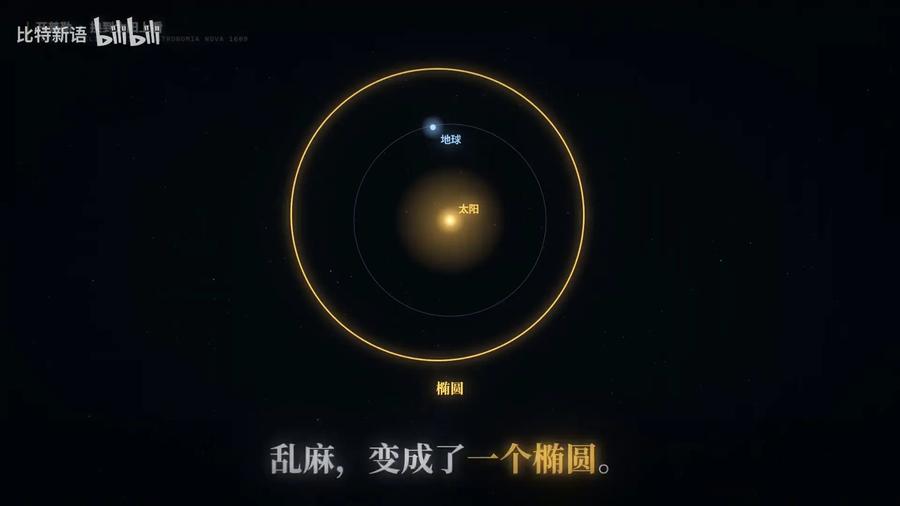
参照系从地球移到太阳,视角一换,原本杂乱的轨迹立刻被整理成一条简单的椭圆:
由此,开普勒三定律诞生了:
- 轨道是椭圆,太阳在焦点上(1609)
- 相同的时间,扫过相同的面积(1609)
- 周期² ∝ 半长轴³(1619)
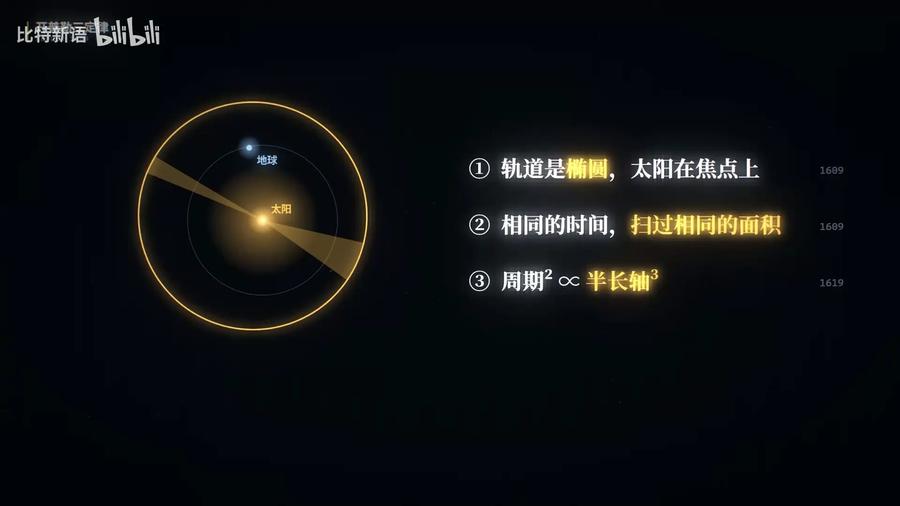
三条定律适用于火星、地球、木星等所有行星——用极少的规则,概括了第谷二十多年的观测数据。这是一次伟大的压缩。
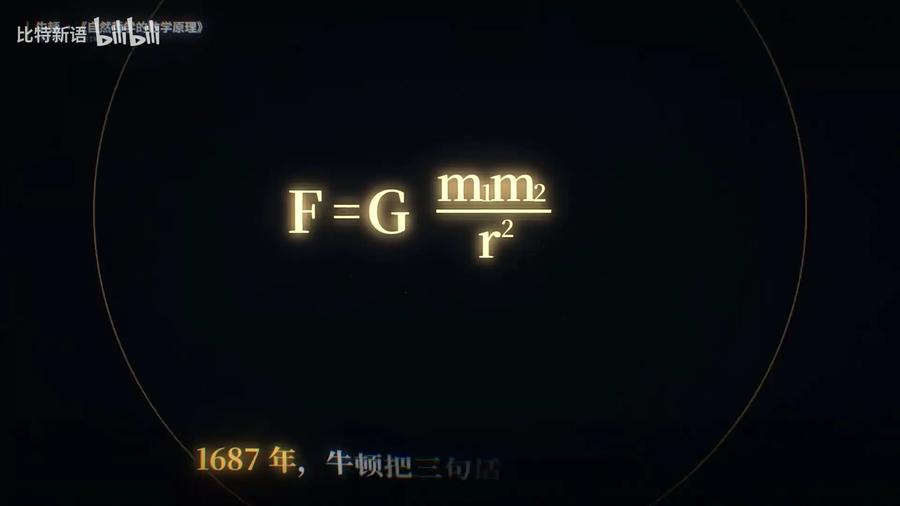
但压缩还没有结束。1687 年,牛顿出手,用万有引力公式把开普勒的三条定律再压成一行:
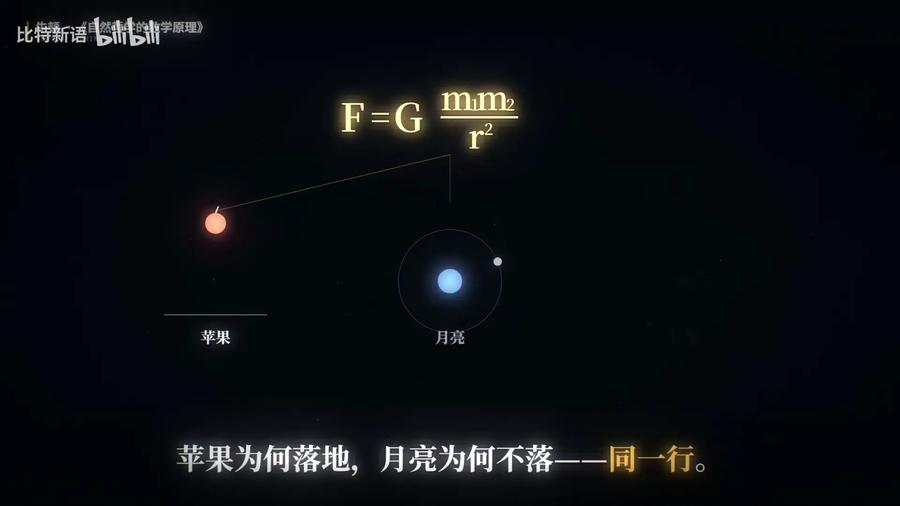
F = G · m₁m₂ / r²
苹果为什么落地,月亮为什么不落——同一行公式,全部解释。
更狠的是:它能算出表格里没有的东西。哈雷据此预言:1682 年那颗彗星,会在 1758 年回来。他没能活到那一天,但彗星准时回来了。
三句话压成一个公式——理解越深,表达越短,预言越准。 这就是"理解能够预言"最硬核的注脚。
四、最短程序:什么是"规律"的数学定义
到这里,"压缩"还只是个直觉。1965 年,算法信息论(Algorithmic Information Theory)给了它一个严格的定义:一个对象的规律含量,等于描述它的最短程序的长度。
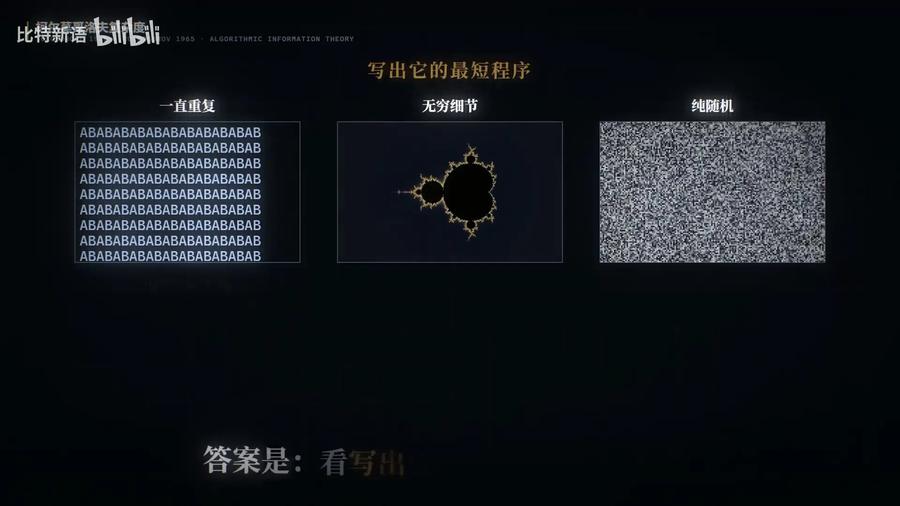
看三类对象:
- 一直重复:
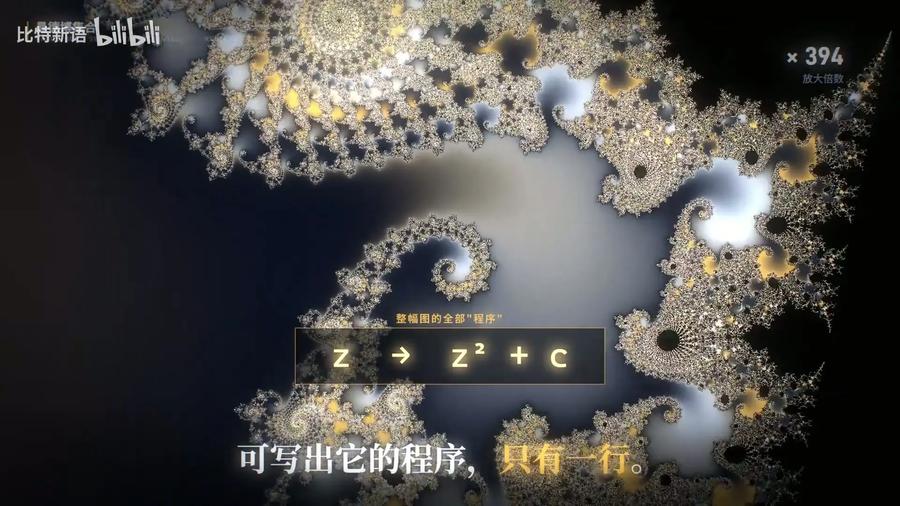
ABABAB…,可以写成"AB" × 500,程序很短; - 无穷细节:分形图案,无论放大多少倍,细节都不重复——从 ×4.1 放大到 ×433,依然层层有新东西。
听起来分形最复杂?恰恰相反。整幅图的全部"程序",只有一行:z → z² + c。
- 纯随机:比如一片雪花的噪声图案。看着最简单,却一点都压不掉——原始 129,600 字节,压缩后还是 129,600 字节,省下 0%。
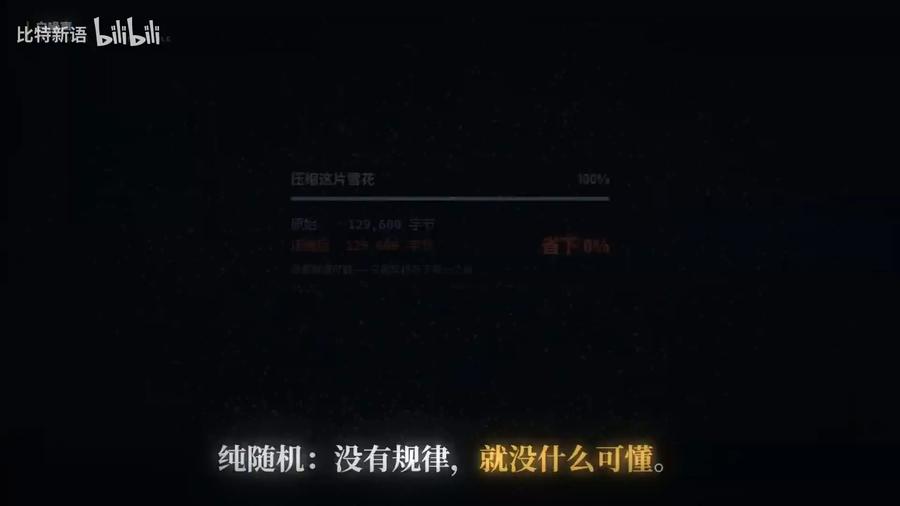
纯随机给出了一条反面的智慧:没有规律,就没什么可懂。 压缩不了的东西,就是理解不了的东西。
五、理解的代价是放弃:从百万像素到一只猫
压缩有一个绕不开的代价:它是有损的。
你看一只猫,眼睛收到的是几百万个光点:
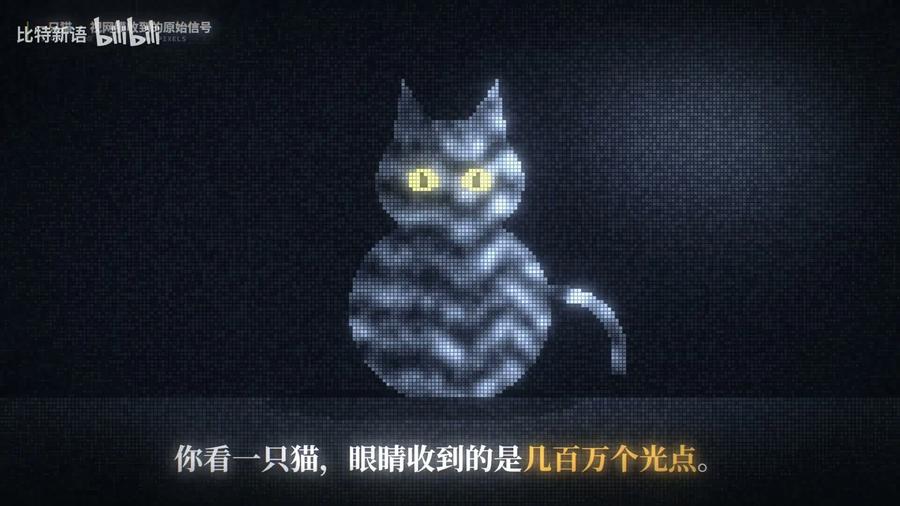
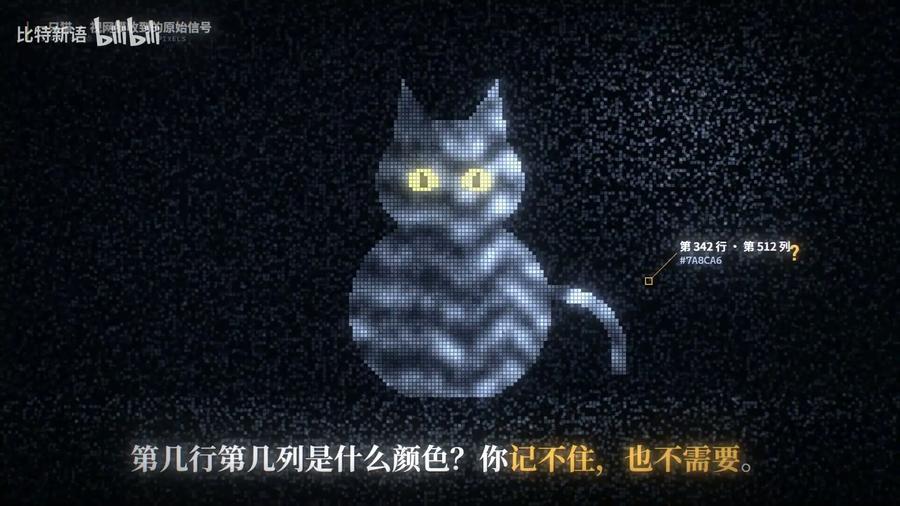
第 342 行、第 512 列的像素是什么颜色(#7A8CA6?)——你记不住,也不需要记住。
大脑会扔掉光影和噪点,只保留耳朵、胡须、竖瞳这些关键特征,然后识别出:猫。
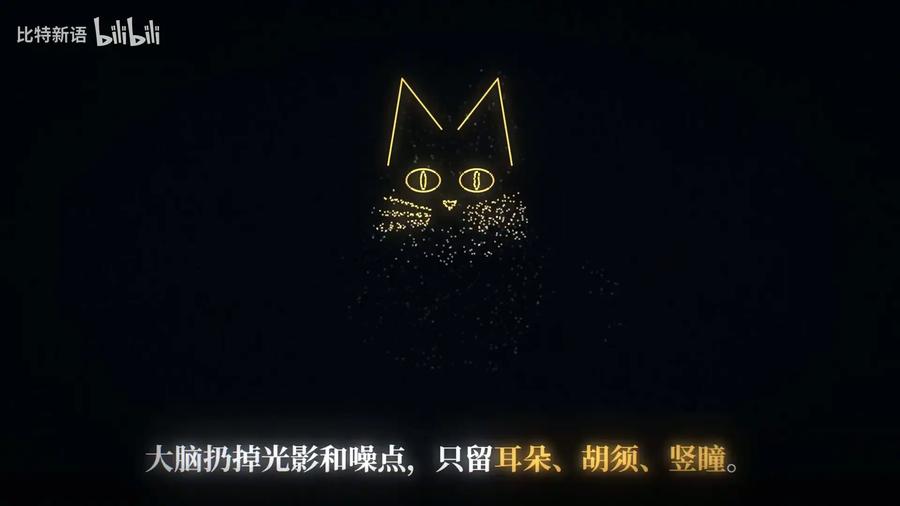
继续压缩下去,最后只剩下一个"猫"字。于是核心命题出现了:
理解的代价,是放弃。
把每个细节都记住,不叫懂,叫死记硬背。真正的理解必须舍弃无关细节,抽取可以泛化的结构。这也解释了一个常见的学习误区:为什么有人笔记做得比书还厚,合上书却什么都说不出来——他做了无损存储,却没有做有损压缩。
六、机器只学一件事:压缩与预测
这套逻辑不只属于人类。现在,有一种机器也只学一件事——读一段字,猜下一个字。
给它一句"今天的天气真好",它给出的候选是:不(41%)、热(18%)、冷(12%)、糟(9%)……
这个游戏还能升级。给它一段侦探小说:座钟停在十一点十五分,窗下只有一行来时的脚印,侄女用左手写信,医生袖口沾着新墨水——然后让它预测"凶手就是——"。它会给每个嫌疑人打分:医生 37%,管家 20%,园丁 20%,侄女 18%。
你大概已经认出来了:这就是今天的大语言模型。它从互联网上读过的万亿文字里,压缩出了语言、知识乃至推理的模式,然后用"猜下一个词"的方式,把理解变成了预言。
机器和人,在这一刻殊途同归。
结语:学习的本质,是找更短的描述
把整趟旅程串起来:
- 记住是把世界存下来——500 个偶数,1,947 个字符;
- 理解是把世界压小——一个
2n,2 个字符; - 压缩的能力 = 预测的能力:猜得越准,记得越少;
- 第谷的数据被开普勒压成椭圆,被牛顿压成一行,被哈雷用来预言未来;
- 规律 = 最短程序;压不动的东西,就是不懂的东西;
- 理解是有损的:你必须敢于放弃细节,才能得到结构;
- 无论人脑还是 AI,做的都是同一件事:压缩,然后预言。
所以下次学习的时候,不妨用"压缩"来检验自己:合上书,你能用几句话说清楚它?如果答案接近书的厚度,那是记住;如果只有几行,而且能让你推导出书里没有的东西——那才是理解。
记住只能复述,理解能够预言。